早稲田大学教授に聞く、大規模言語モデル研究者に聞く、RAGが100%にならない二つの理由
公開日 更新日
社内の資料を検索させて、その内容をもとにAIに答えさせる。RAGと呼ばれるこの仕組みは、AIの出まかせを抑える本命として、多くの現場で導入が進んでいます。手元の資料に基づいて答えるのだから、少なくとも根拠のない話は減るはずだ——そう考えたくなります。
モデルを実際につくり、その出来を測る側にいる早稲田大学・河原大輔教授に尋ねると、特別な作り込みをしない場合の精度は「8割9割」で、作り込んでも100%には届かない、という答えでした。
この記事でたどるのは、RAGの間違いがどこで生まれるのか、そして社内で使うなら何をどう測ればよいのか、という順序です。
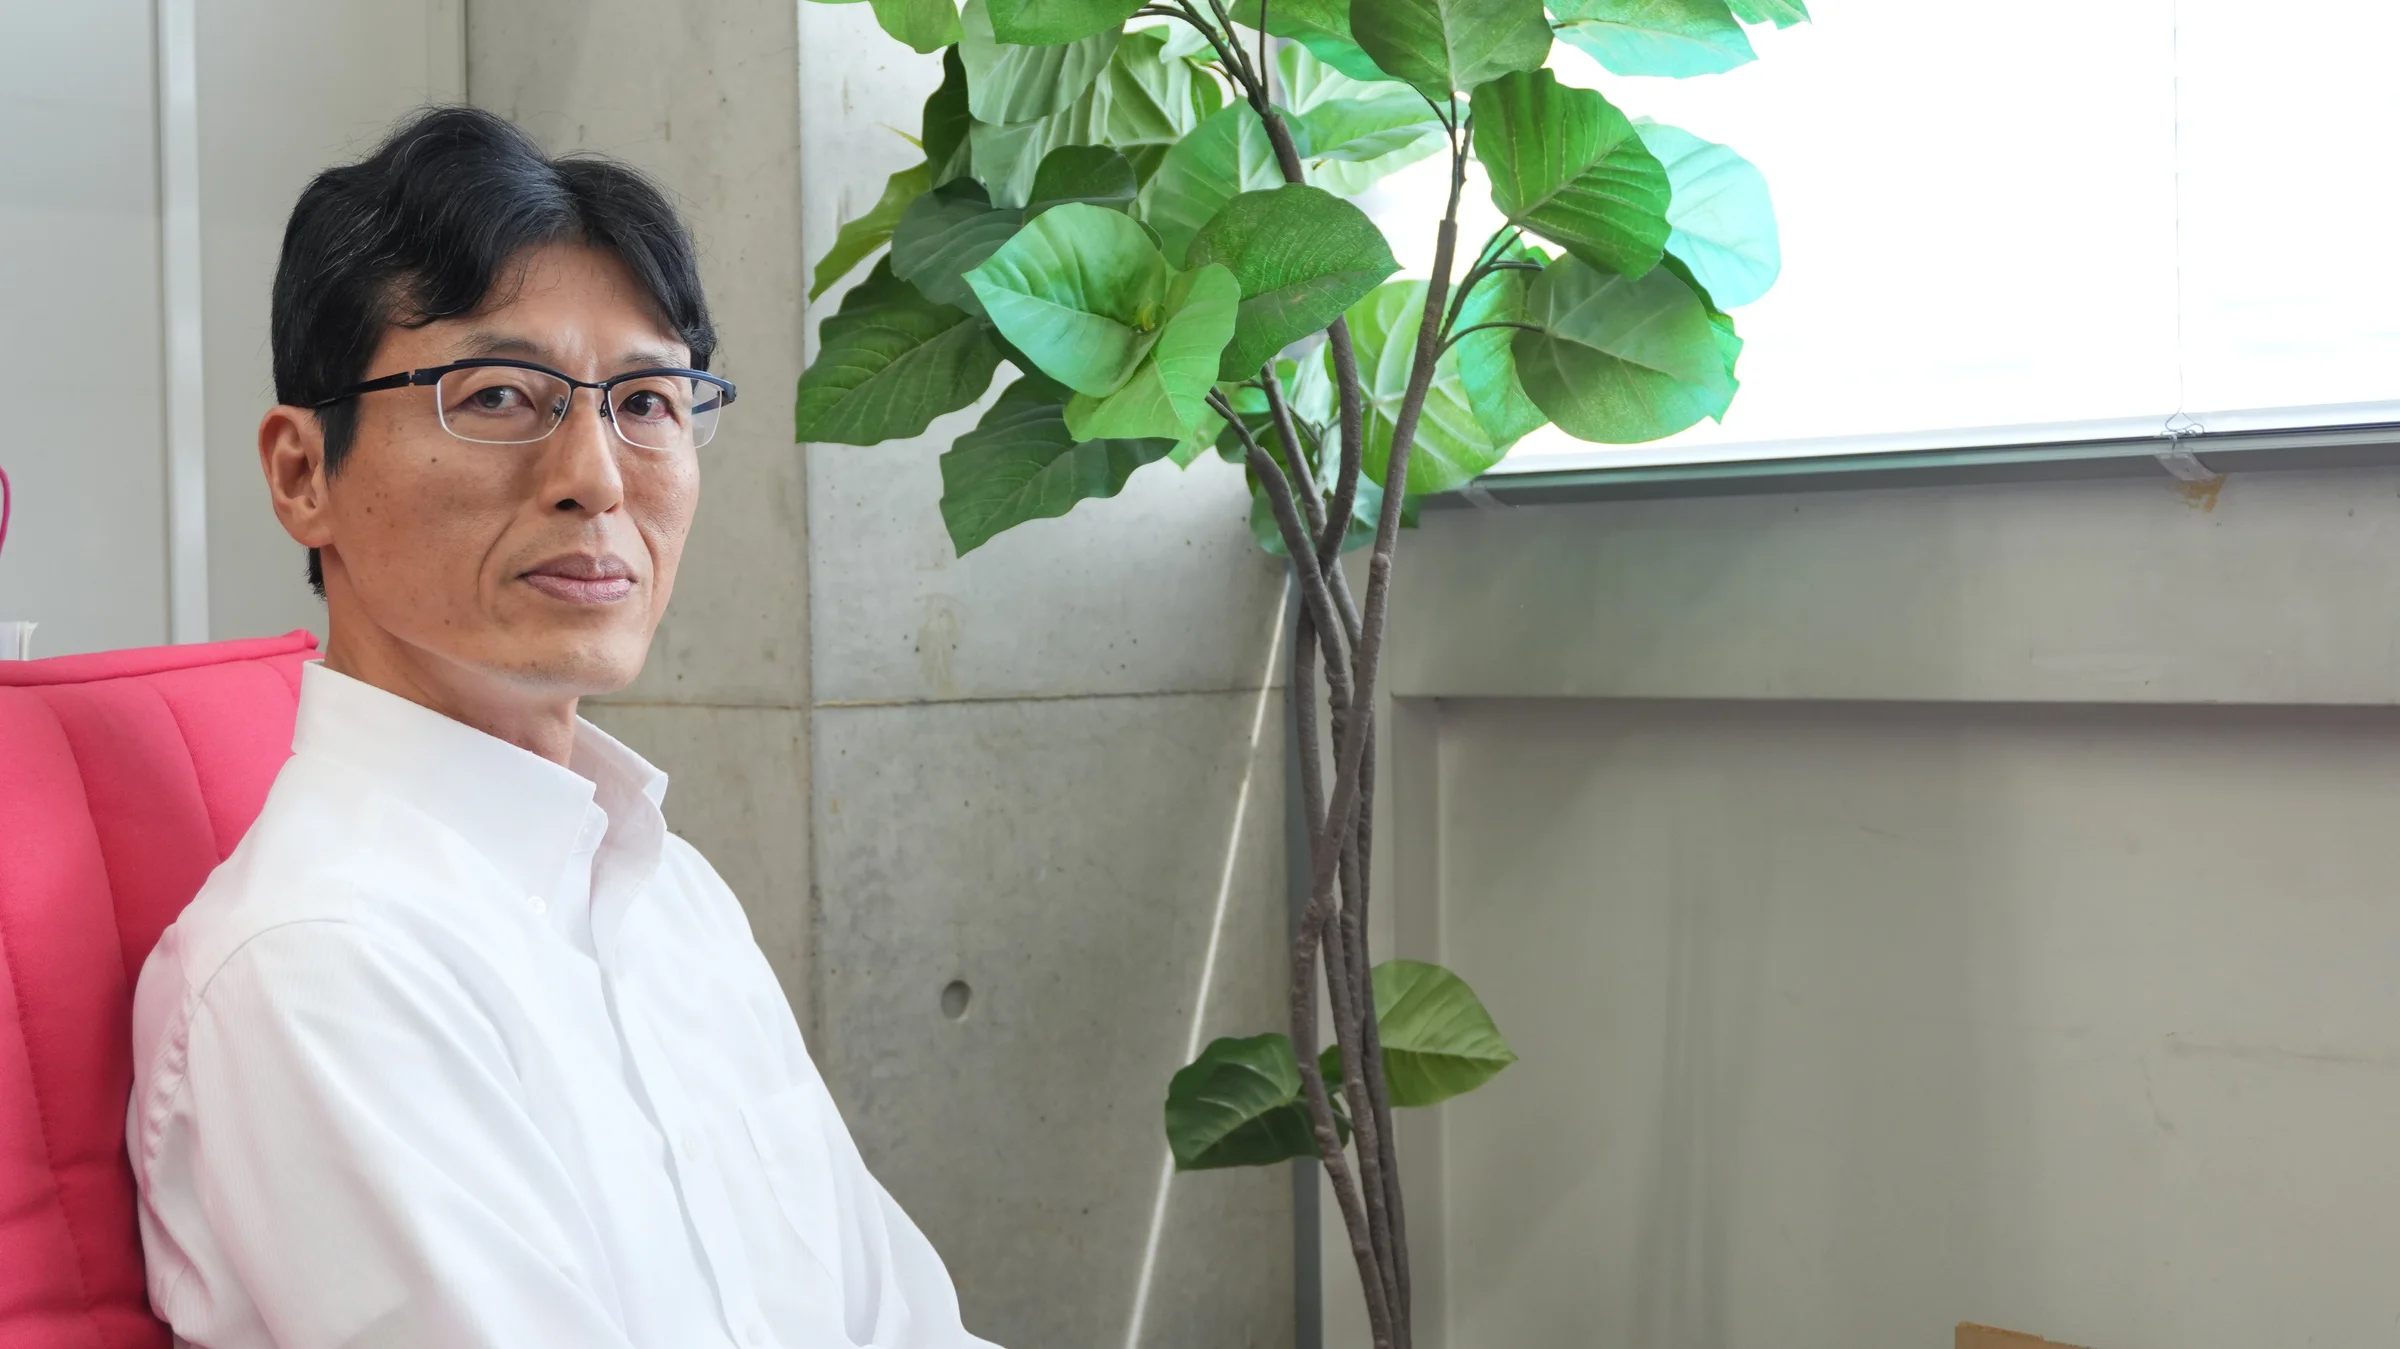
河原 大輔(かわはら・だいすけ)
早稲田大学 理工学術院 基幹理工学部 教授国立情報学研究所 客員教授専門分野:自然言語処理、大規模言語モデル日本語を中心に、大規模言語モデルの構築・評価・応用に取り組む。日本語の言語理解ベンチマーク「JGLUE」の構築で、言語処理学会の最優秀論文賞を受賞。
何も調整しなければ、社内AIの検索は「8割9割」
| RAG(検索拡張生成)とは |
|---|
| 質問に関係しそうな文書をまず検索し、その文書を材料にしてAIに答えを作らせる仕組み。モデルが学習していない社内資料や新しい情報でも扱えるようになるため、根拠のない回答を抑える手段として使われています。 |
手元にある大量の資料から数値を探させたい。既存のモデルをそのまま使い、特別な作り込みをしない場合、どの程度の精度になるのか。河原教授の答えは「8割9割とかですかね」でした。
裏を返せば、10件に1件から2件は取り違える計算になります。正確な数字を引くために導入したはずの仕組みが、その水準で止まる。しかも教授は、作り込んでいけば100%に届く、とも言いません。
ここに、RAGを評価するときの要点が入っています。間違いが起きる場所が、一つではないということです。
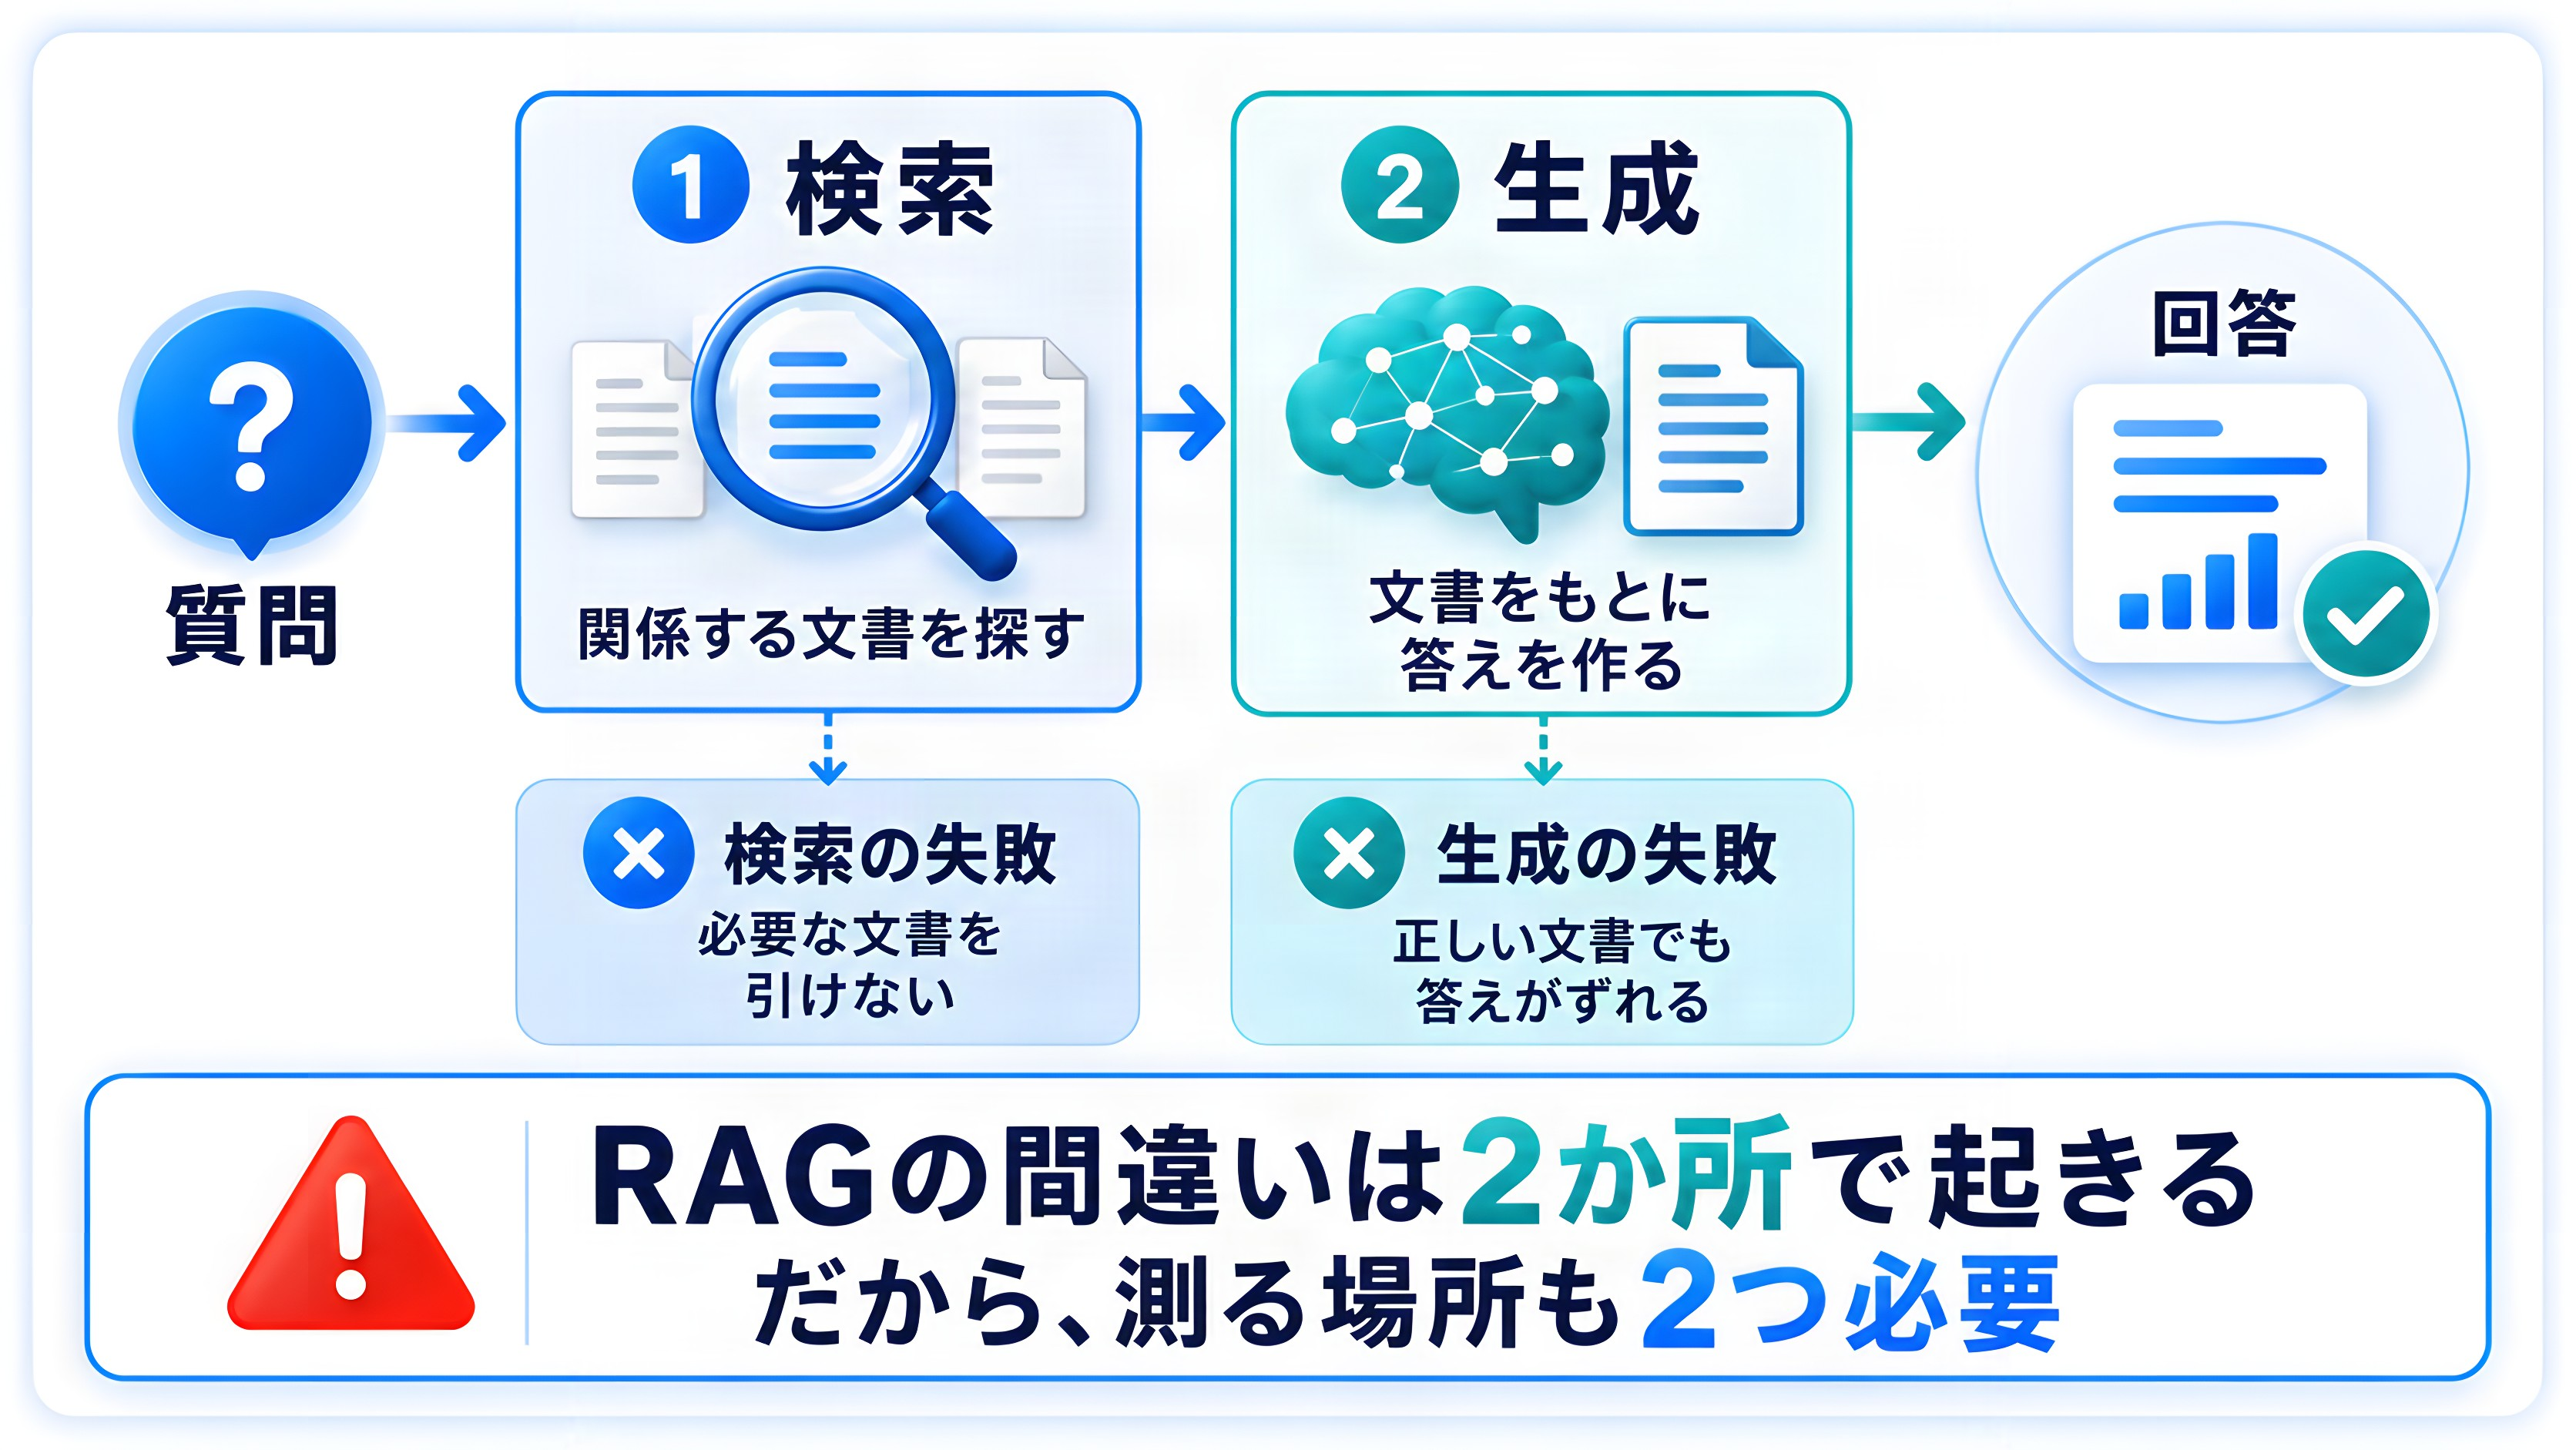
間違いは2か所で起きる。だから、測る場所も2つ要ります
RAGをひとつの箱として見ていると、「当たった」「外れた」しか分かりません。実際には、外れ方が二種類あります。
- ・検索の失敗——質問に関係する資料そのものを引いてこられない
- ・生成の失敗——正しい資料を引いてきたのに、そこから作る答えが資料とずれる
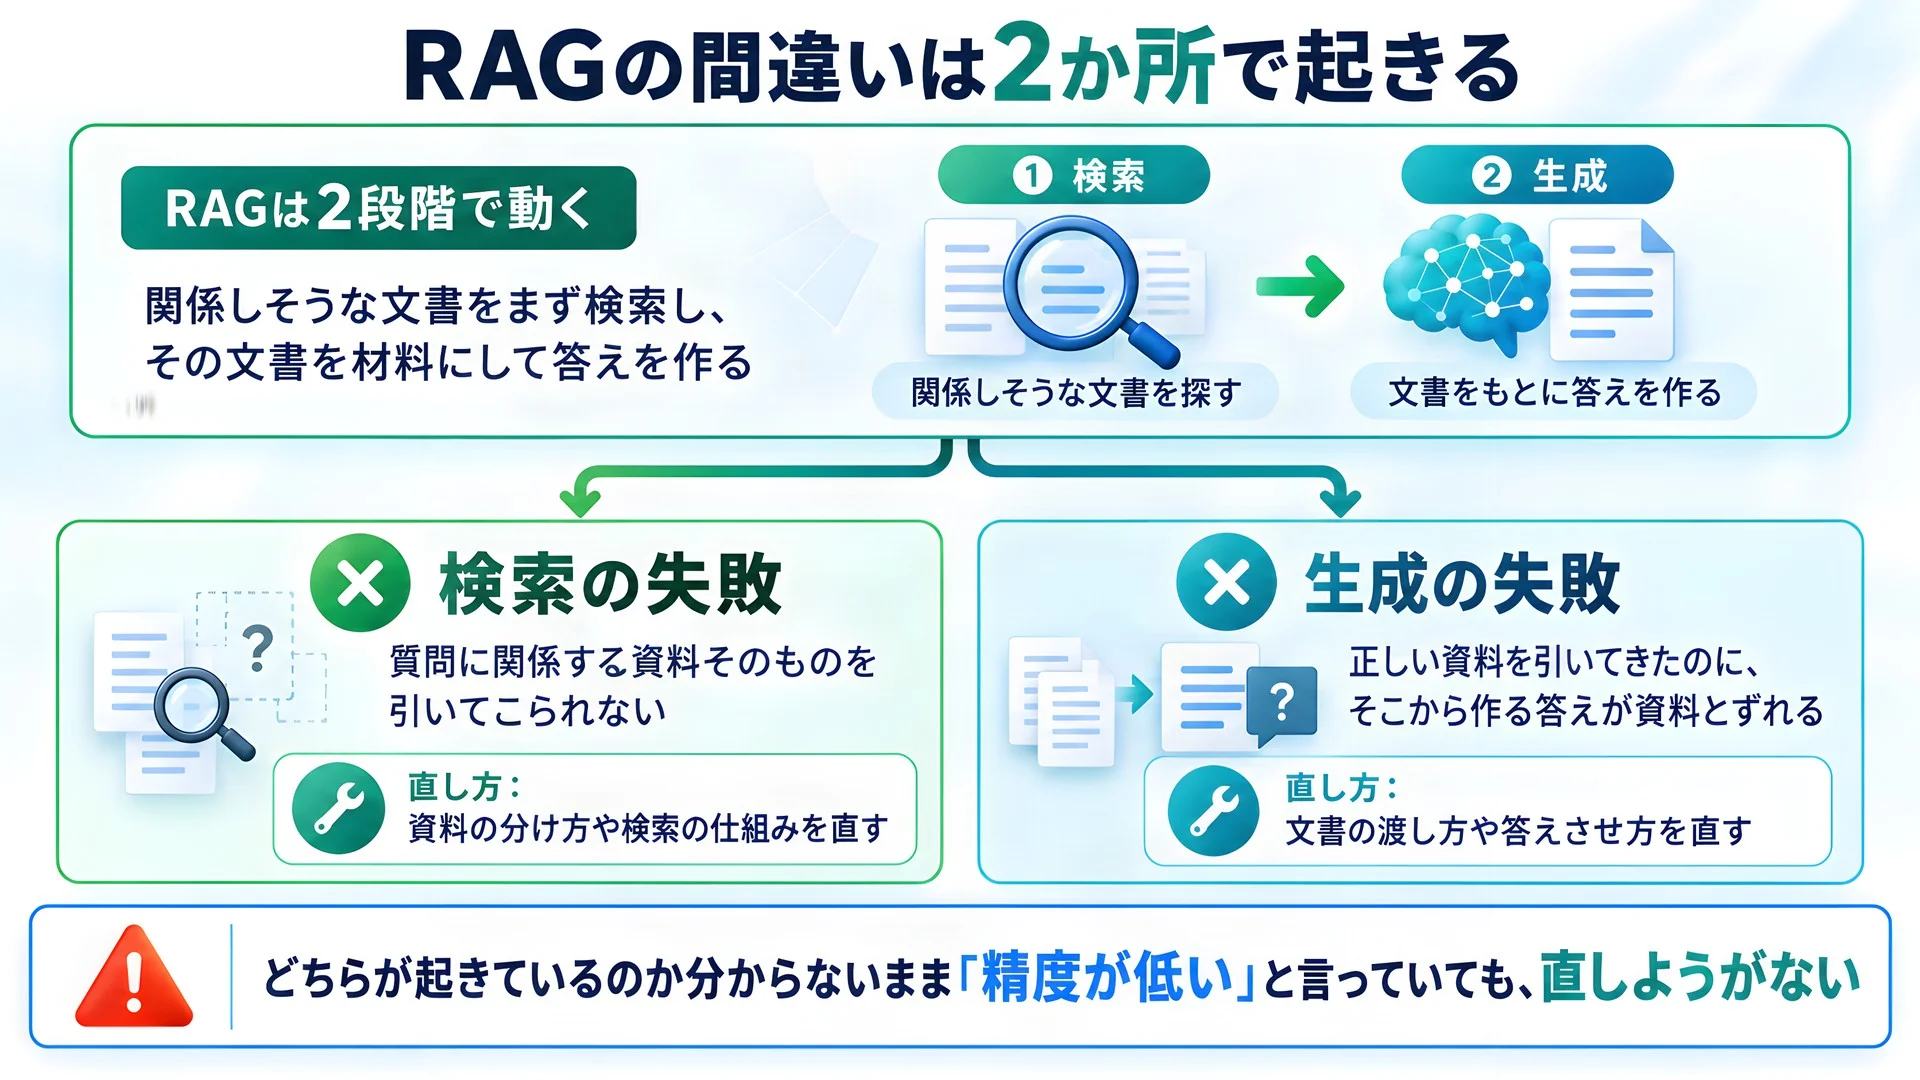
この二つは、手当ての仕方がまったく違います。前者なら、資料の分け方や検索の仕組みを直すことになります。後者なら、引いてきた文書の渡し方や、答えさせ方を直すことになります。どちらが起きているのか分からないまま「精度が低い」と言っていても、直しようがありません。
クリティカルな分野ではなおさらだ、と断ったうえで、教授が挙げた評価の設計は、この二段構えにそのまま対応しています。
| 評価セットとは |
|---|
| あらかじめ正解を用意した質問の一覧です。同じ一覧をモデルや設定を変えて解かせることで、変更で良くなったのか悪くなったのかを数字で比べられます。 |
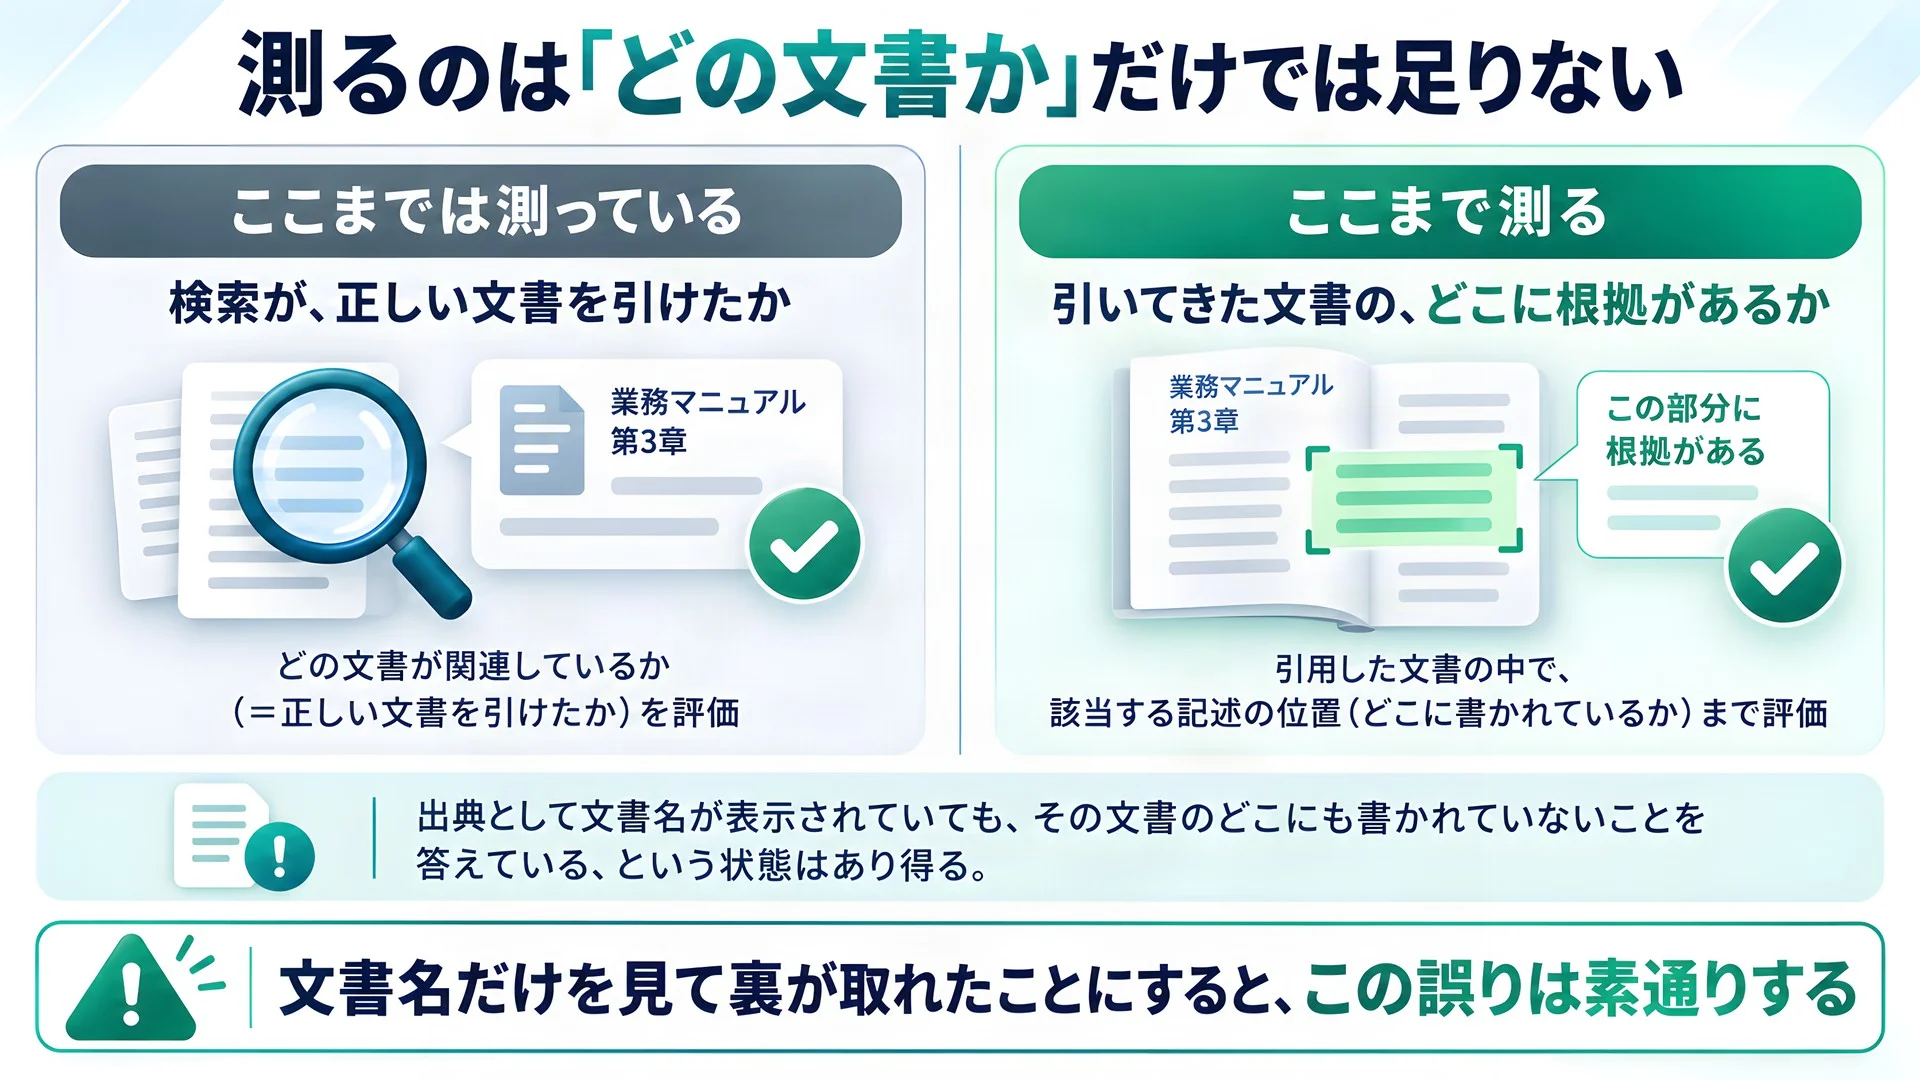
注目したいのは、「どの文書を使ったか」だけでなく「その文書のどこに根拠があるか」まで測る、という点です。出典として文書名が表示されていても、その文書のどこにも書かれていないことを答えている、という状態はあり得ます。文書名だけを見て裏が取れたことにしてしまうと、この誤りは素通りします。
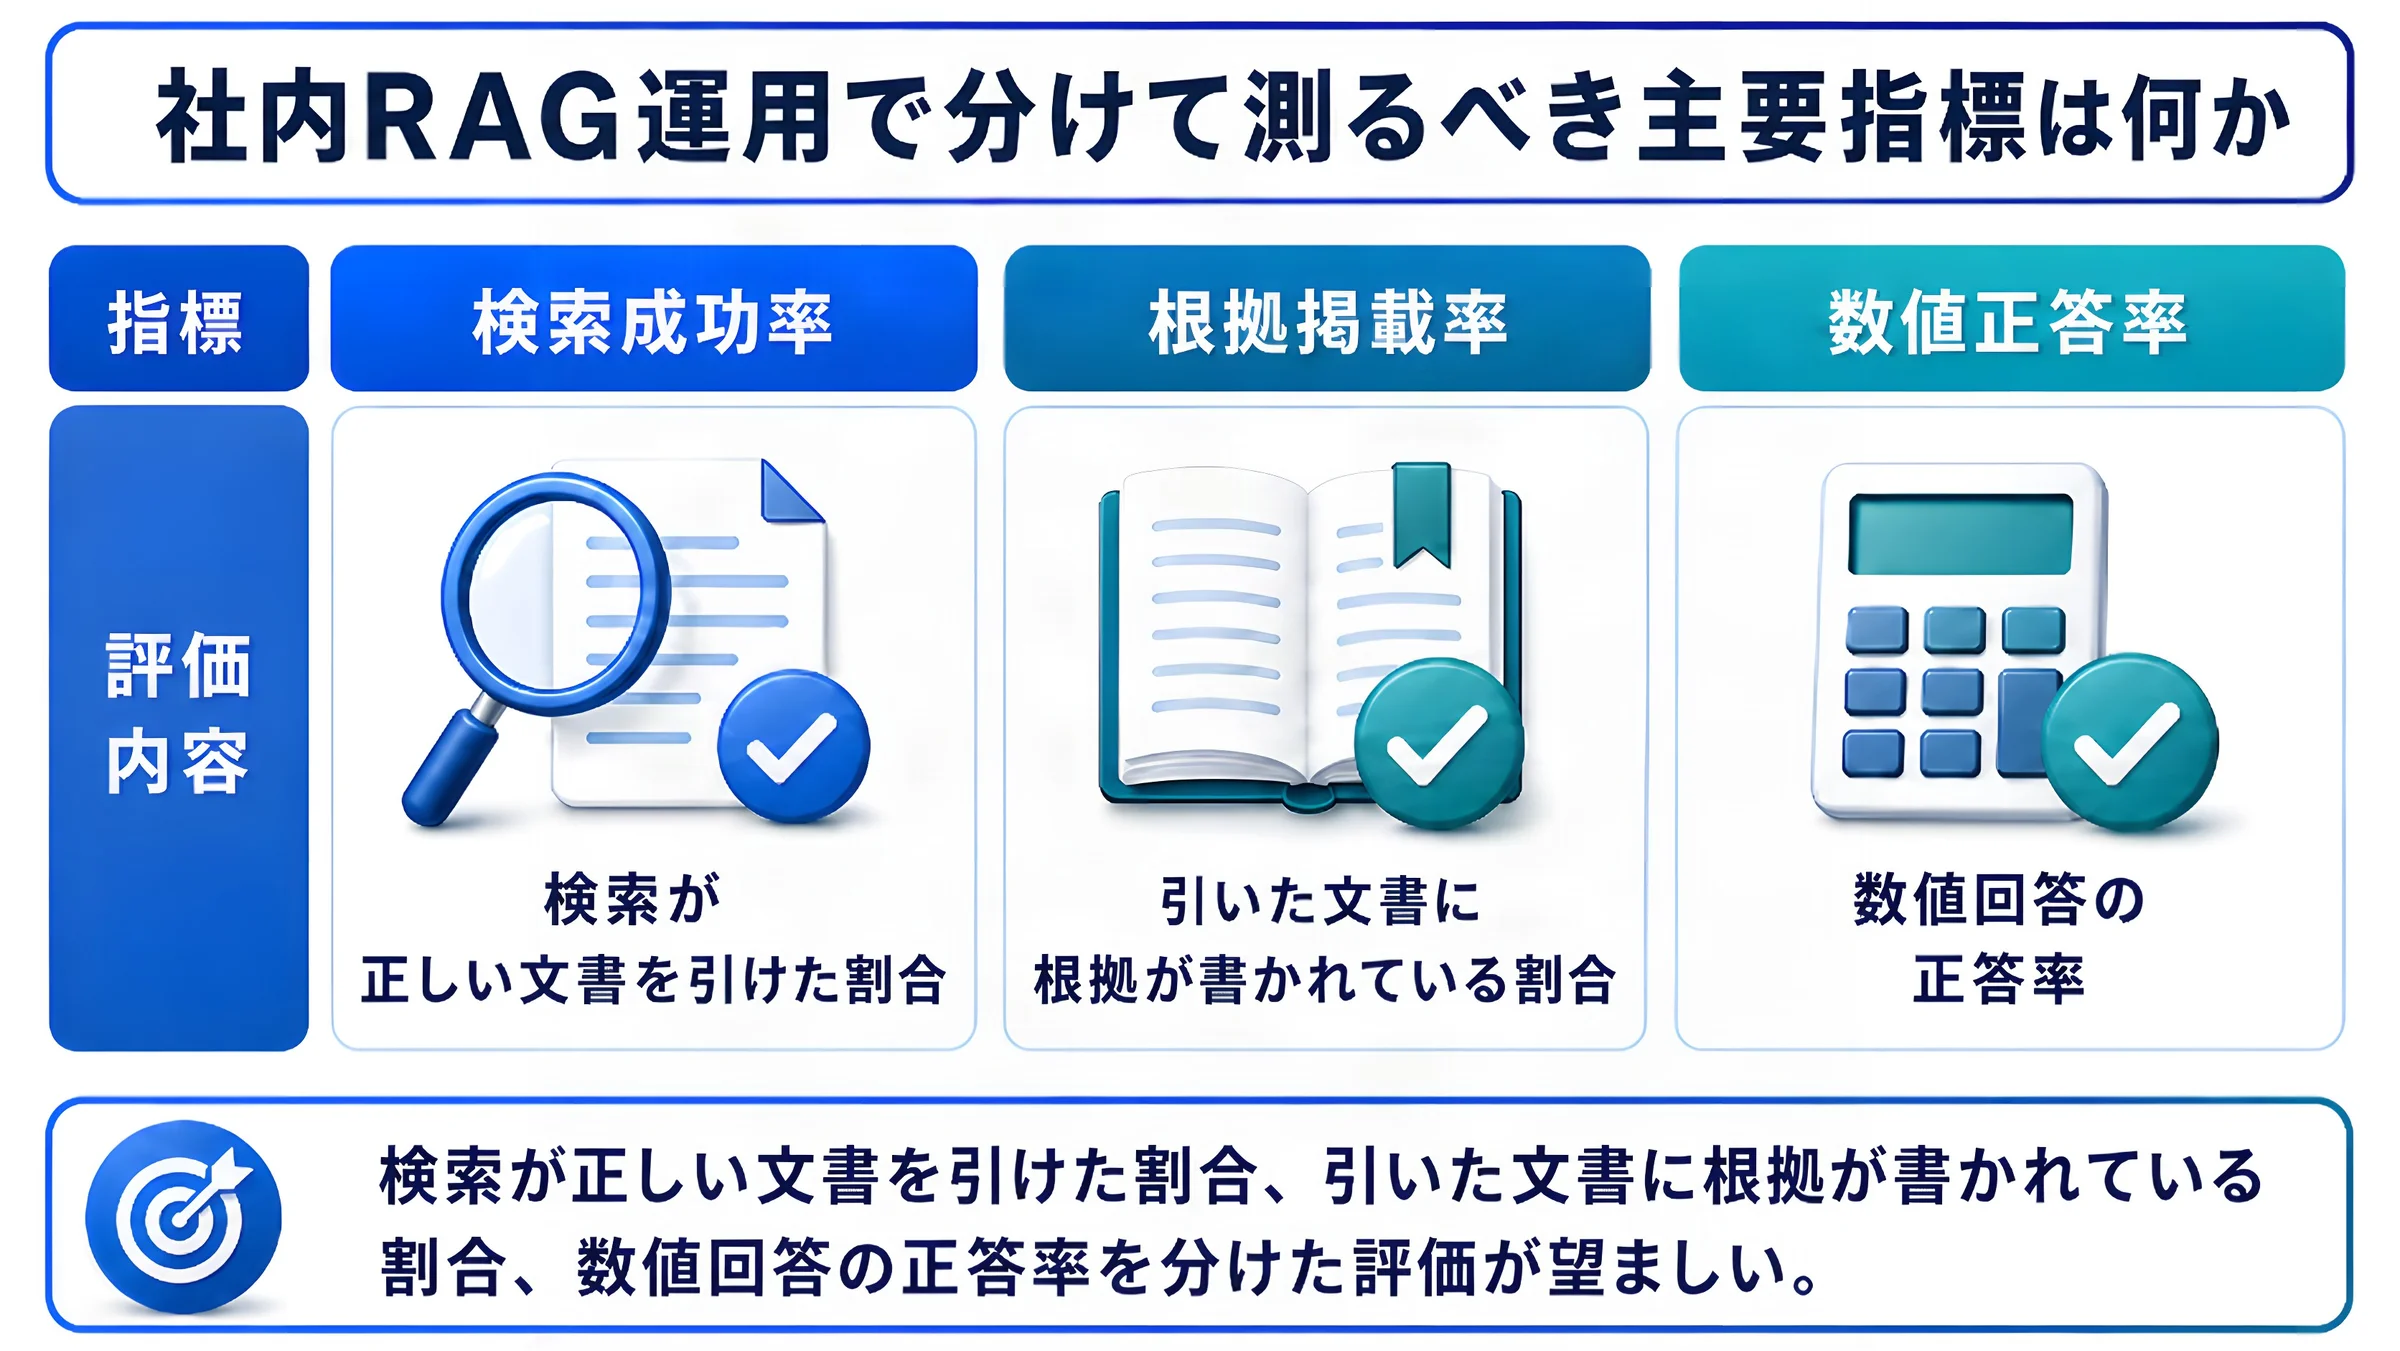
社内でRAGを運用するなら、少なくとも次の三つは分けて測っておきたいところです。
- ・検索が、正しい文書を引けた割合
- ・引いてきた文書に、答えの根拠が実際に書かれている割合
- ・金額や件数など、数値を答えさせる質問だけを取り出した正答率(全体の平均に埋もれさせない)
精度が上がるほど、使う側の警戒はゆるみます。表計算ソフトの自動計算のように「間違えないもの」として扱ってしまう人もいるのではないか、と水を向けると、教授は「警戒せずに使っている人は、いますよね」と応じました。生成AIの間違いは今後どんどん人間よりも減っていくだろう、自動運転と同じで——という見通しも示したうえで、「人間と同じですし、その評価精度だけでは測れない部分ももちろんあります。人間も間違えます」と続けます。
人間より間違いが少なくなったとしても、間違いがなくなるわけではありません。評価セットで測れる範囲にも限りがあります。この二つを踏まえたうえで、どこまでを自動に任せ、どこから人が見るのかを決める。それが運用設計ということになります。
AIを使ったかどうかではなく、成果物が要件を満たしているか
生成AIを使って書かれたものを、どう評価すればよいのか。自分の中にはなかった知識を持ってきて組み合わせ、ひとつの論文を仕上げてしまえる状況について尋ねると、教授の基準は「使ったかどうか」ではありませんでした。
論文には「新規性がある」「提案手法がある」「実験でその有効性が示されている」という、満たすべき要件がはっきりあります。要件が明確なら、それを満たしているかどうかで判断できる。どう作ったかを問い詰める必要は、そこでは生じません。
問題は、要件がはっきりしていない場合です。そのようなレポートの問題について教授は、「そこらじゅうの大学で発生していると思いますね」と言います。「先生が学生にレポートを書かせて、学生がAIに書かせたものを提出し、本人のために全くなっていない、みたいな」ことも起きている、と。
編集の現場に置き換えれば、「AIを使ったかどうか」を申告させるルールより、その原稿が満たすべき要件を先に決めておくほうが機能します。一次資料にあたっているか。数字が原典と一致しているか。取材で得た独自の情報が入っているか。これらは、AIを使ったかどうかとは無関係に確認できる項目です。逆に、要件を言葉にできていないまま「AI利用は申告すること」とだけ決めても、通すか通さないかの判断は最後まで残ります。
原稿を通す前に確かめる要件は、たとえば次のように書き出しておきます。
- ・一次資料にあたっているか
- ・数字が原典と一致しているか
- ・取材で得た独自の情報が入っているか
- ・判断の根拠が、原稿の中で示されているか
禁止しないという前提から始める
学生のAI利用は、この3年で急速に広がりました。
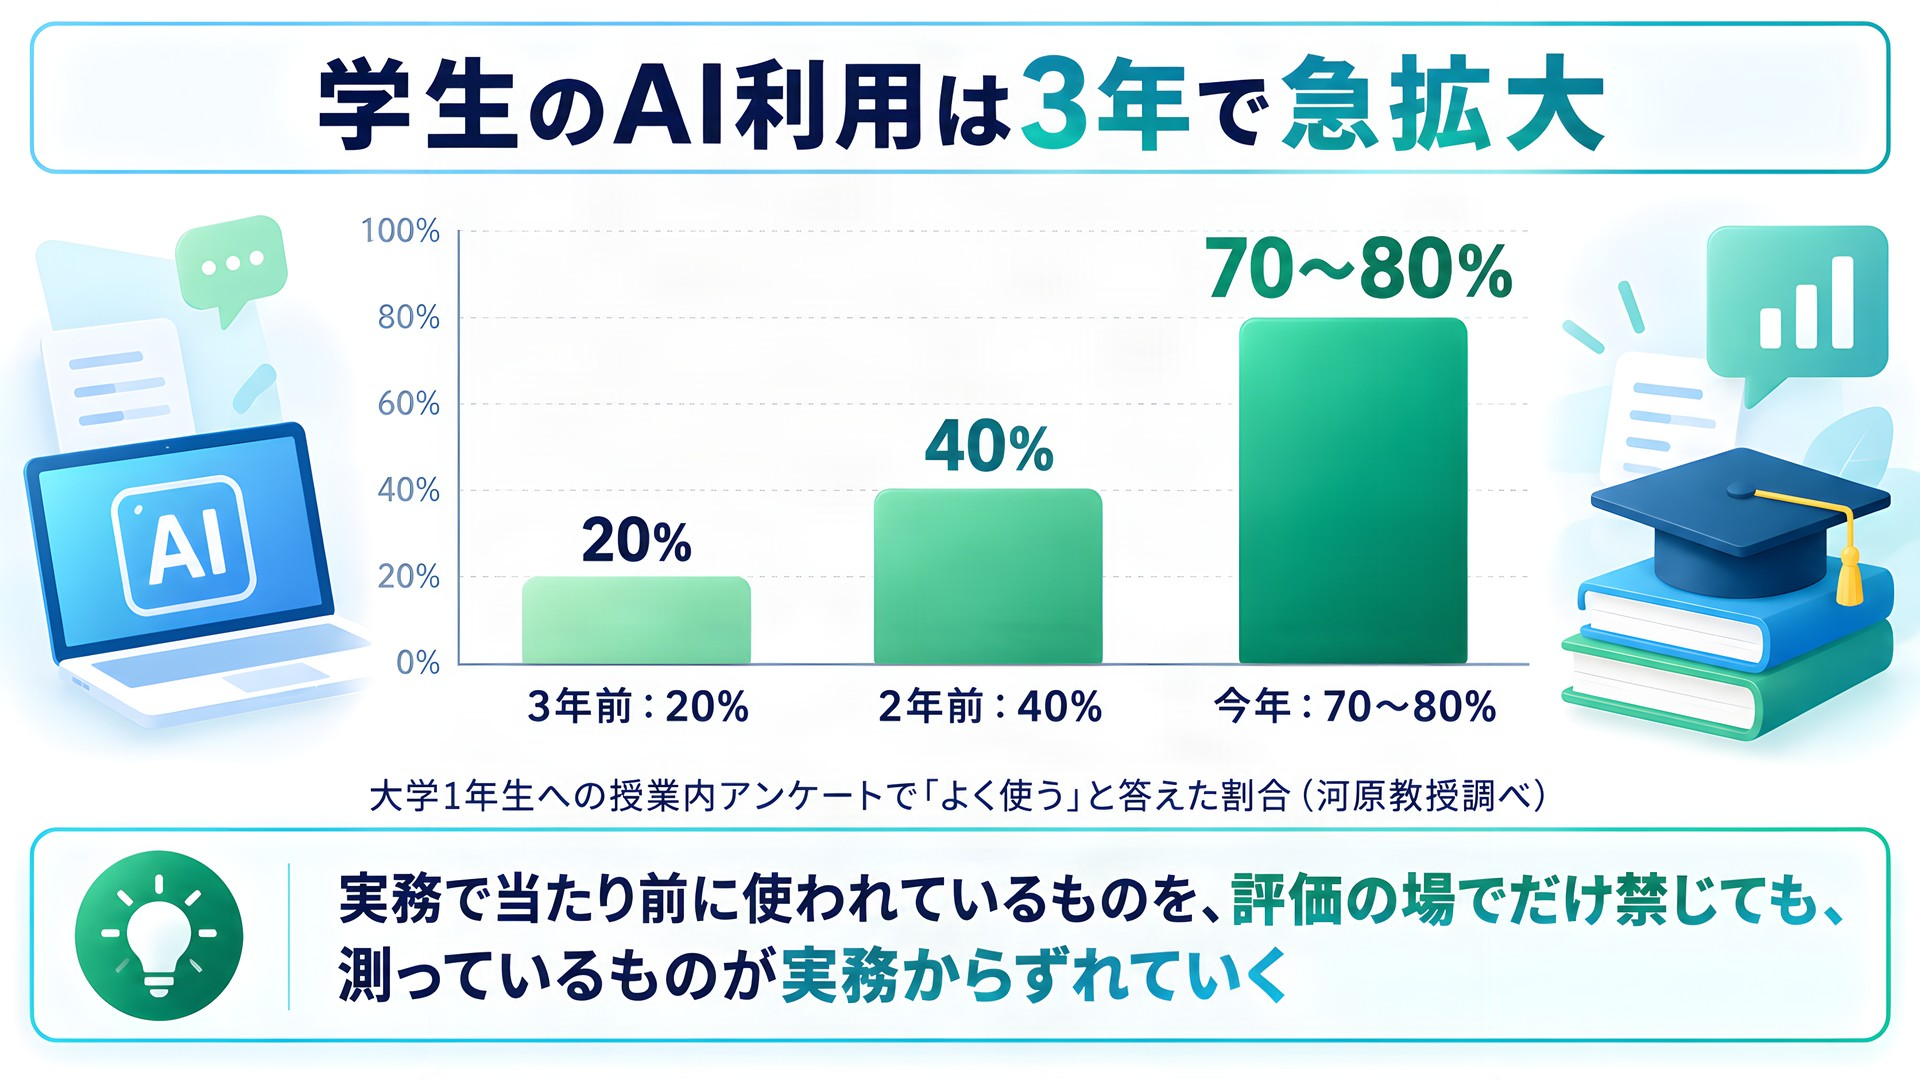
3年で、2割から8割近くへ。ここまで前提が変われば、扱いを決めないという選択肢はなくなります。それでも教授は、禁止という方向を取りません。
「別に、実世界において禁止されていない」。ここが要点です。実務で当たり前に使われているものを、評価の場でだけ禁じても、測っているものが実務からずれていくだけになります。とはいえ、では何をどう測ればよいのかという問いには、まだ答えが出ていません。教授はこれを、世界中の教育が抱えている課題だと言います。
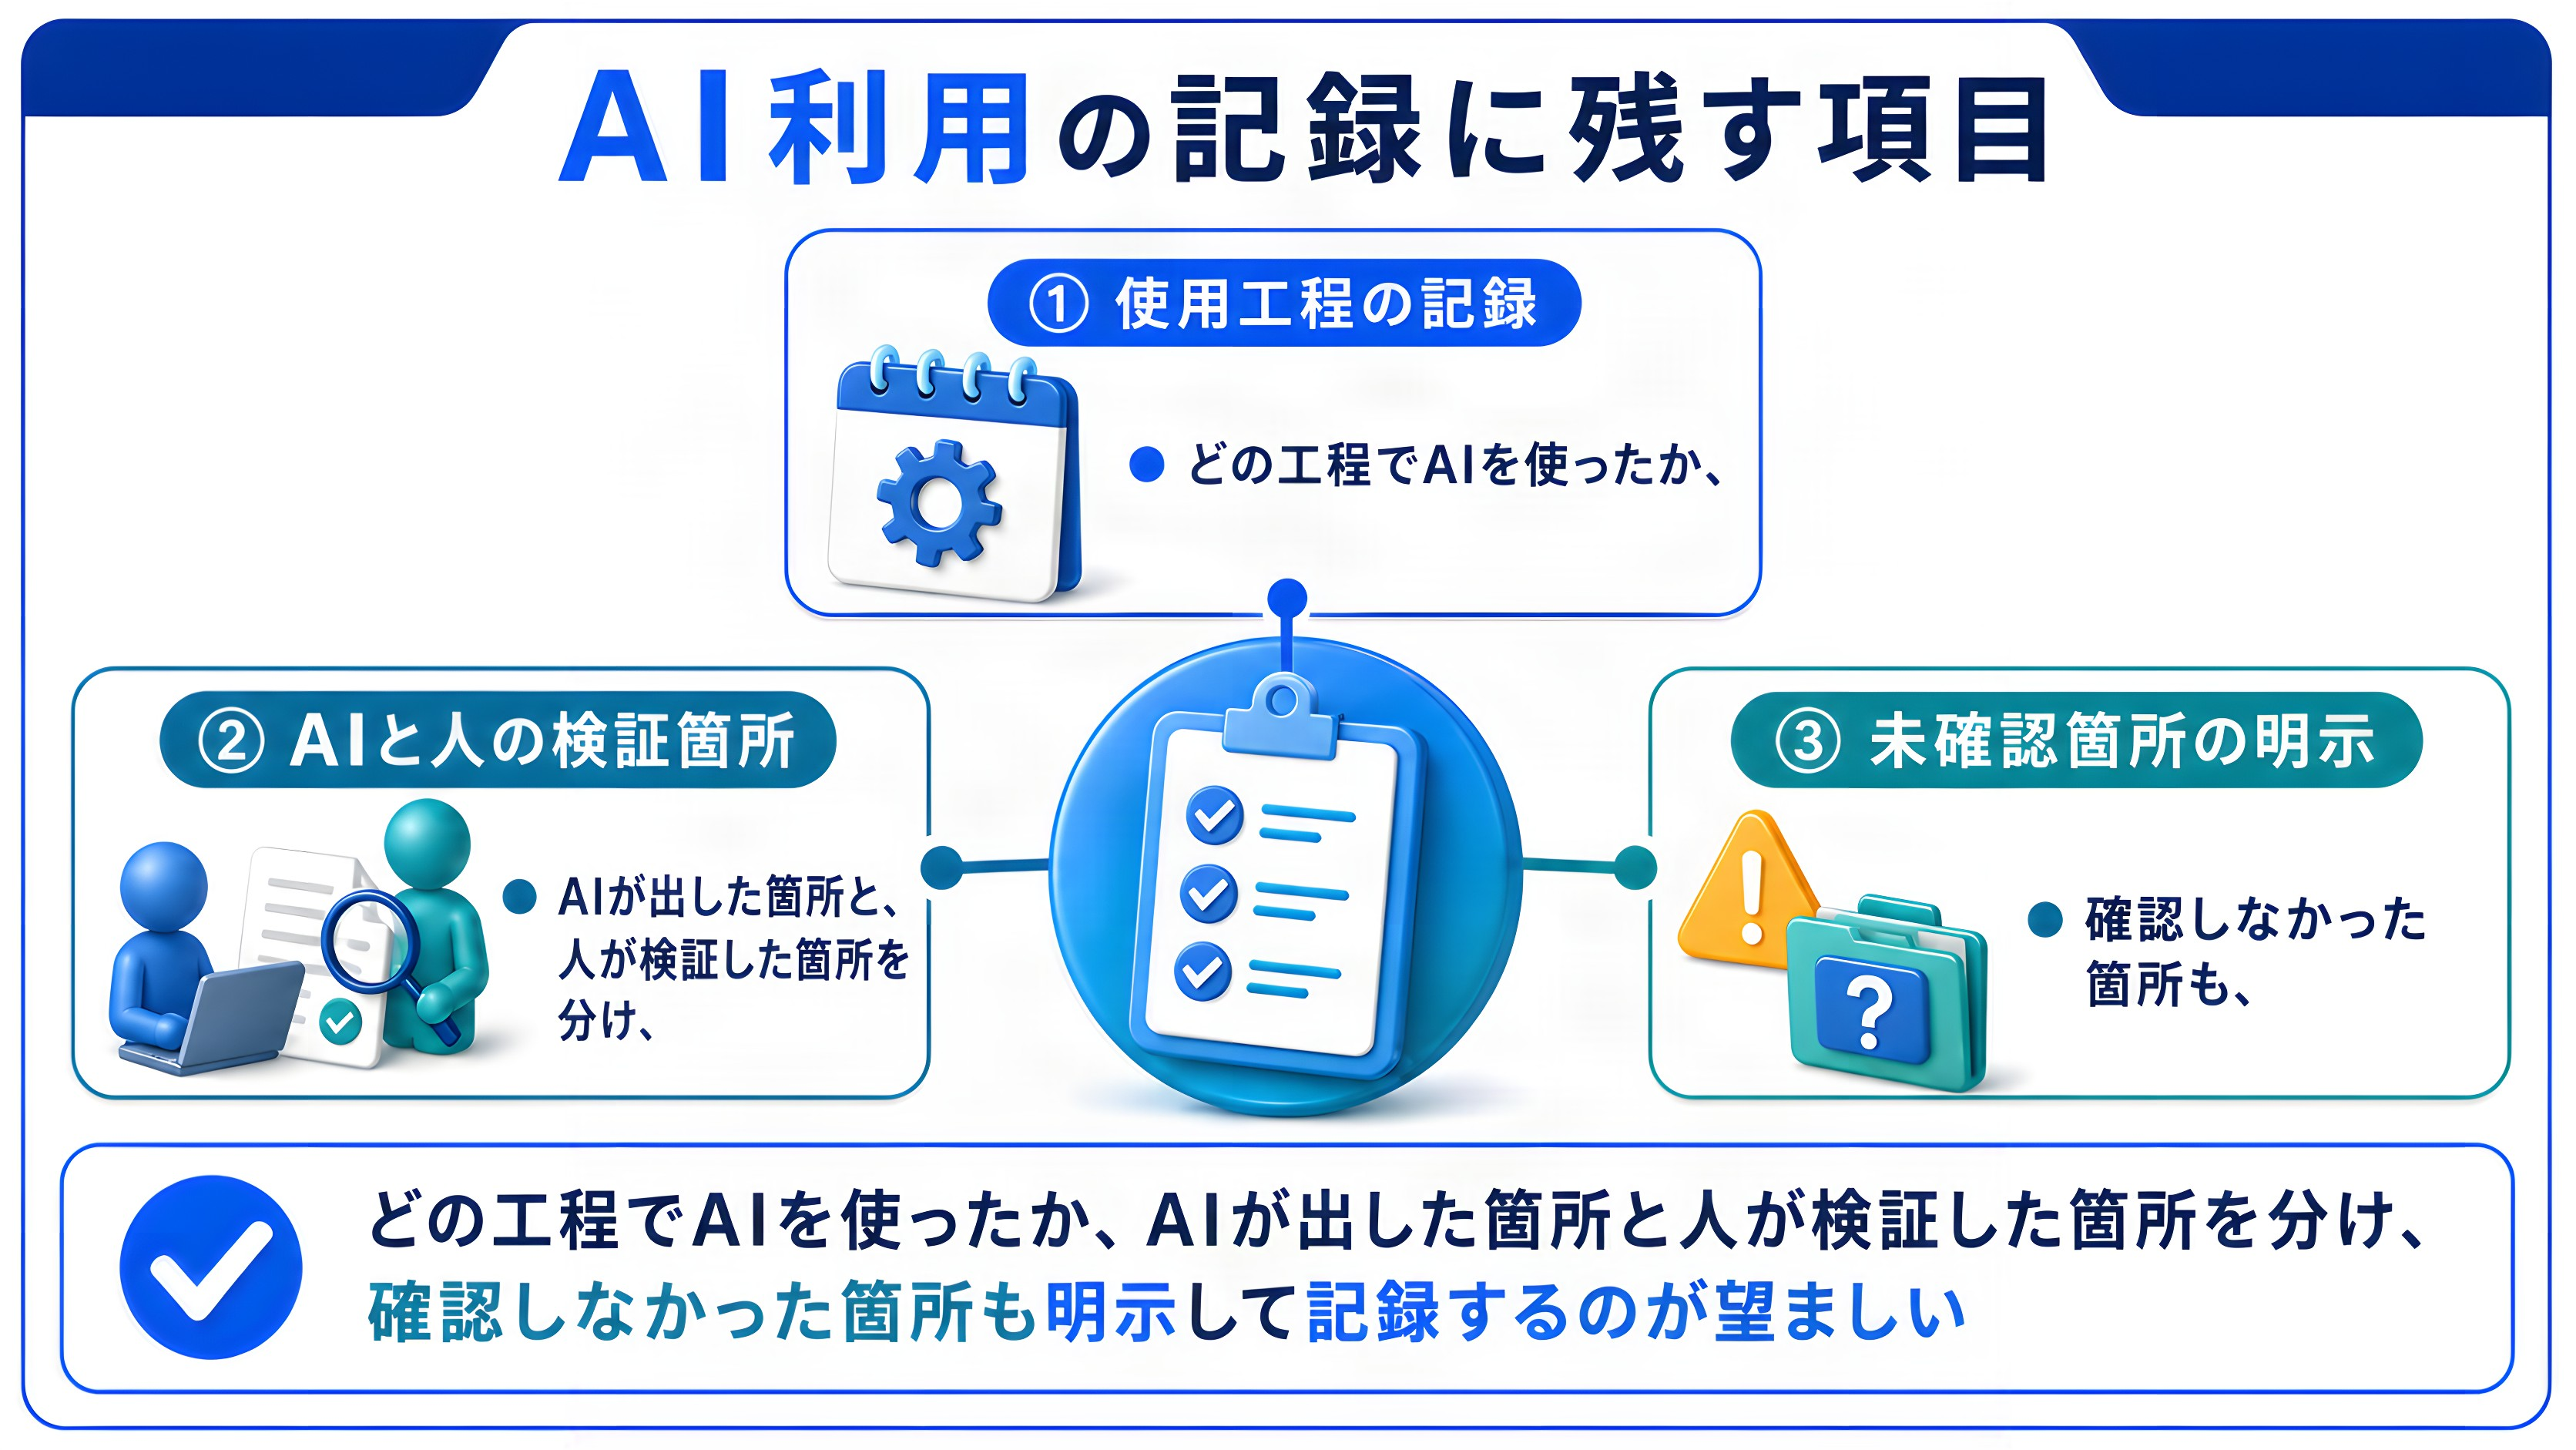
編集部に置き換えても、構図は同じです。使用を禁じるのではなく、使ったうえで何を確認したかを残せる形にしておく。どの工程でAIを使い、どこを人が確かめたのかが後から追える状態にしておけば、問題が起きたときに原因までたどれます。禁止も全面解禁も、この記録を持たないという点では同じです。
使用を記録に残すなら、次の三つを揃えます。
- ・どの工程でAIを使ったかを、原稿ごとに記録する
- ・AIが出した箇所と、人が確かめた箇所を分けて残す
- ・確認しなかった箇所も、確認しなかったと分かる形で残す
RAGを入れても、100%にはなりません。間違いは検索と生成の二か所で起きるので、測る場所も二つ要ります。そして、どの文書を使ったかだけでなく、その文書のどこに根拠があるかまで測って初めて、裏が取れたと言えます。AIを使うかどうかは、もう選ぶ段階を過ぎました。決めるべきなのは、何を満たしていれば通してよいのかという要件のほうです。
取材日:2026年8月17日
撮影:編集部
この記事を書いた人
編集プロダクション雨輝
2014年創業。取材・執筆、編集、校正・校閲、ファクトチェックなど、コンテンツ制作を幅広く手がける編集プロダクション。正確性と信頼性を重視し、専門家への取材や一次情報の確認を通じた、質の高い情報発信に取り組んでいる。https://amaterupro.jp/
専門家監修
関連記事
早稲田大学LLM研究者に聞く、「情報量が足らないくせに、答えたがる」自然言語処理研究者が語る、AIの誤り方
編集プロダクション雨輝
医療広告ガイドライン違反事例|厚労省の49件と、直すときの確認点
 Fact Check Lab編集部
口コミ依頼はどこから違反か|景品表示法のステマ規制、措置命令7件から見る境界線
Fact Check Lab編集部
AIの架空の判例などを米国の裁判所が指摘した件数、2026年は10月までに938件 2025年1年分の527件を超える
Fact Check Lab編集部