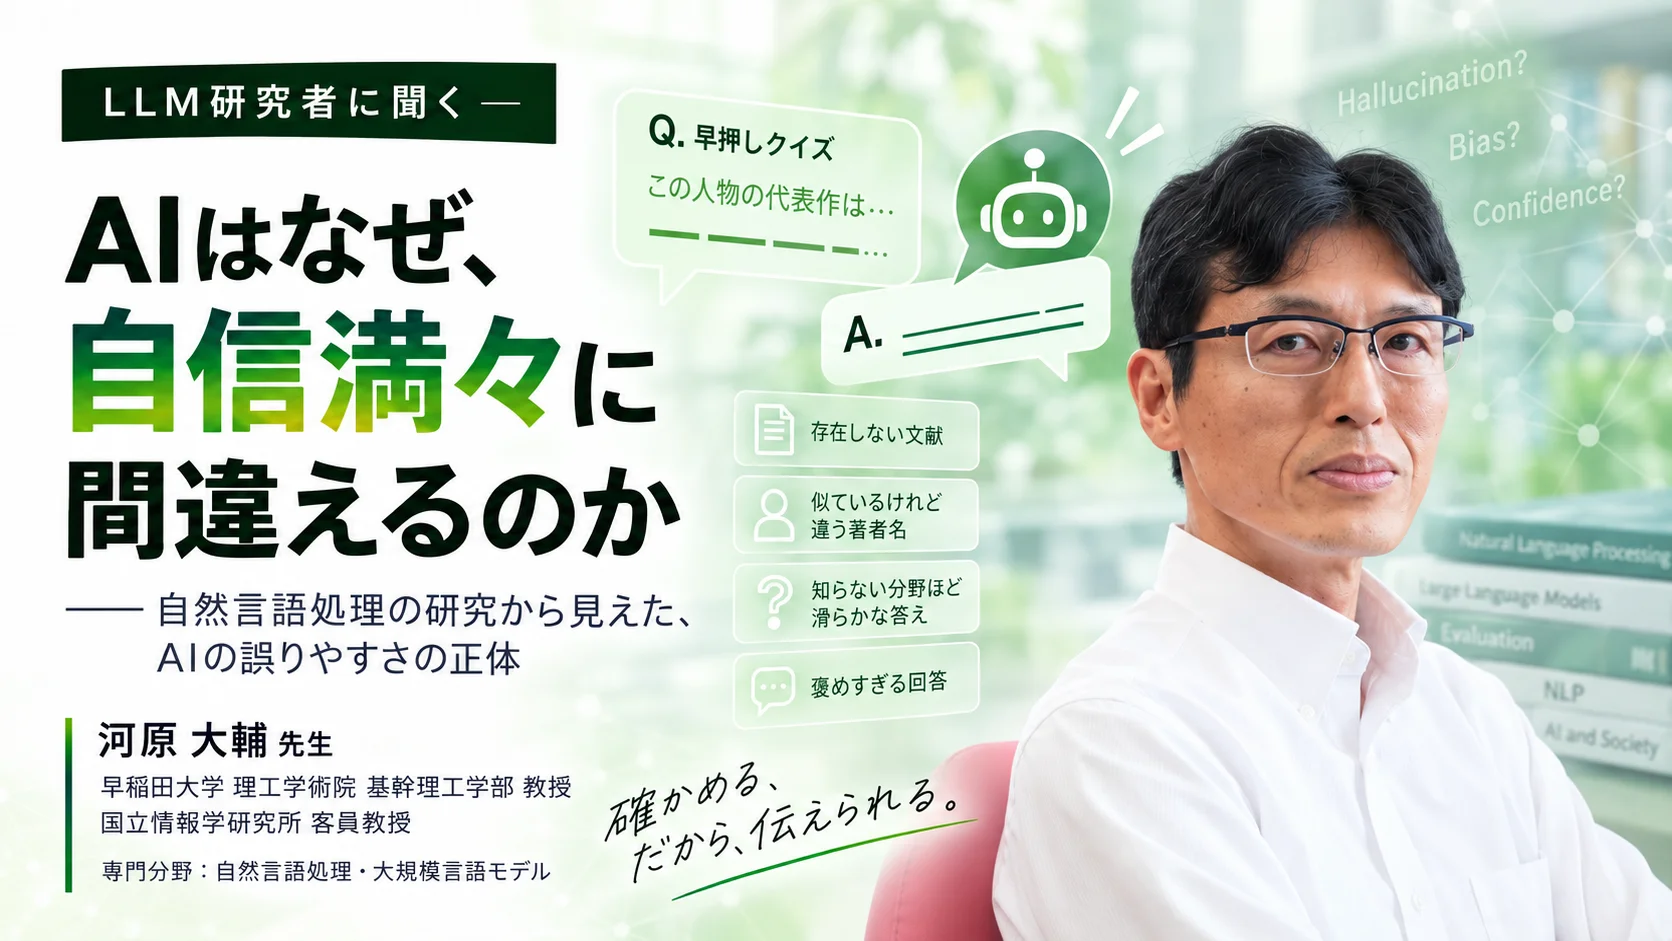
早稲田大学LLM研究者に聞く、「情報量が足らないくせに、答えたがる」自然言語処理研究者が語る、AIの誤り方
公開日 更新日
知らない分野ほど、答えは滑らかになる。惜しい間違い、実在しない著者名、褒めすぎ——誤りには出やすい場所がある
生成AIの答えは、間違っていても口ごもりません。文章は最後まで整っていて、言い淀みもなく、根拠らしきものまで添えられています。編集や検証の現場で厄介なのは、精度そのものより、この見た目の一様さです。どこを疑えばよいのかが、読んだだけでは分かりません。
早稲田大学の河原大輔教授の研究室では、早押しクイズの問題文を途中まで聞かせて、答えの手がかりを探させる、という一風変わった研究をしています。そこで見えたのは、AIが「我慢できない」という性質でした。
この記事で整理するのは、AIの誤りがどこに偏って出るのか、という一点です。誤りが均等にばらまかれているなら、全部を疑うしかありません。ですが、出やすい場所には偏りがありました。
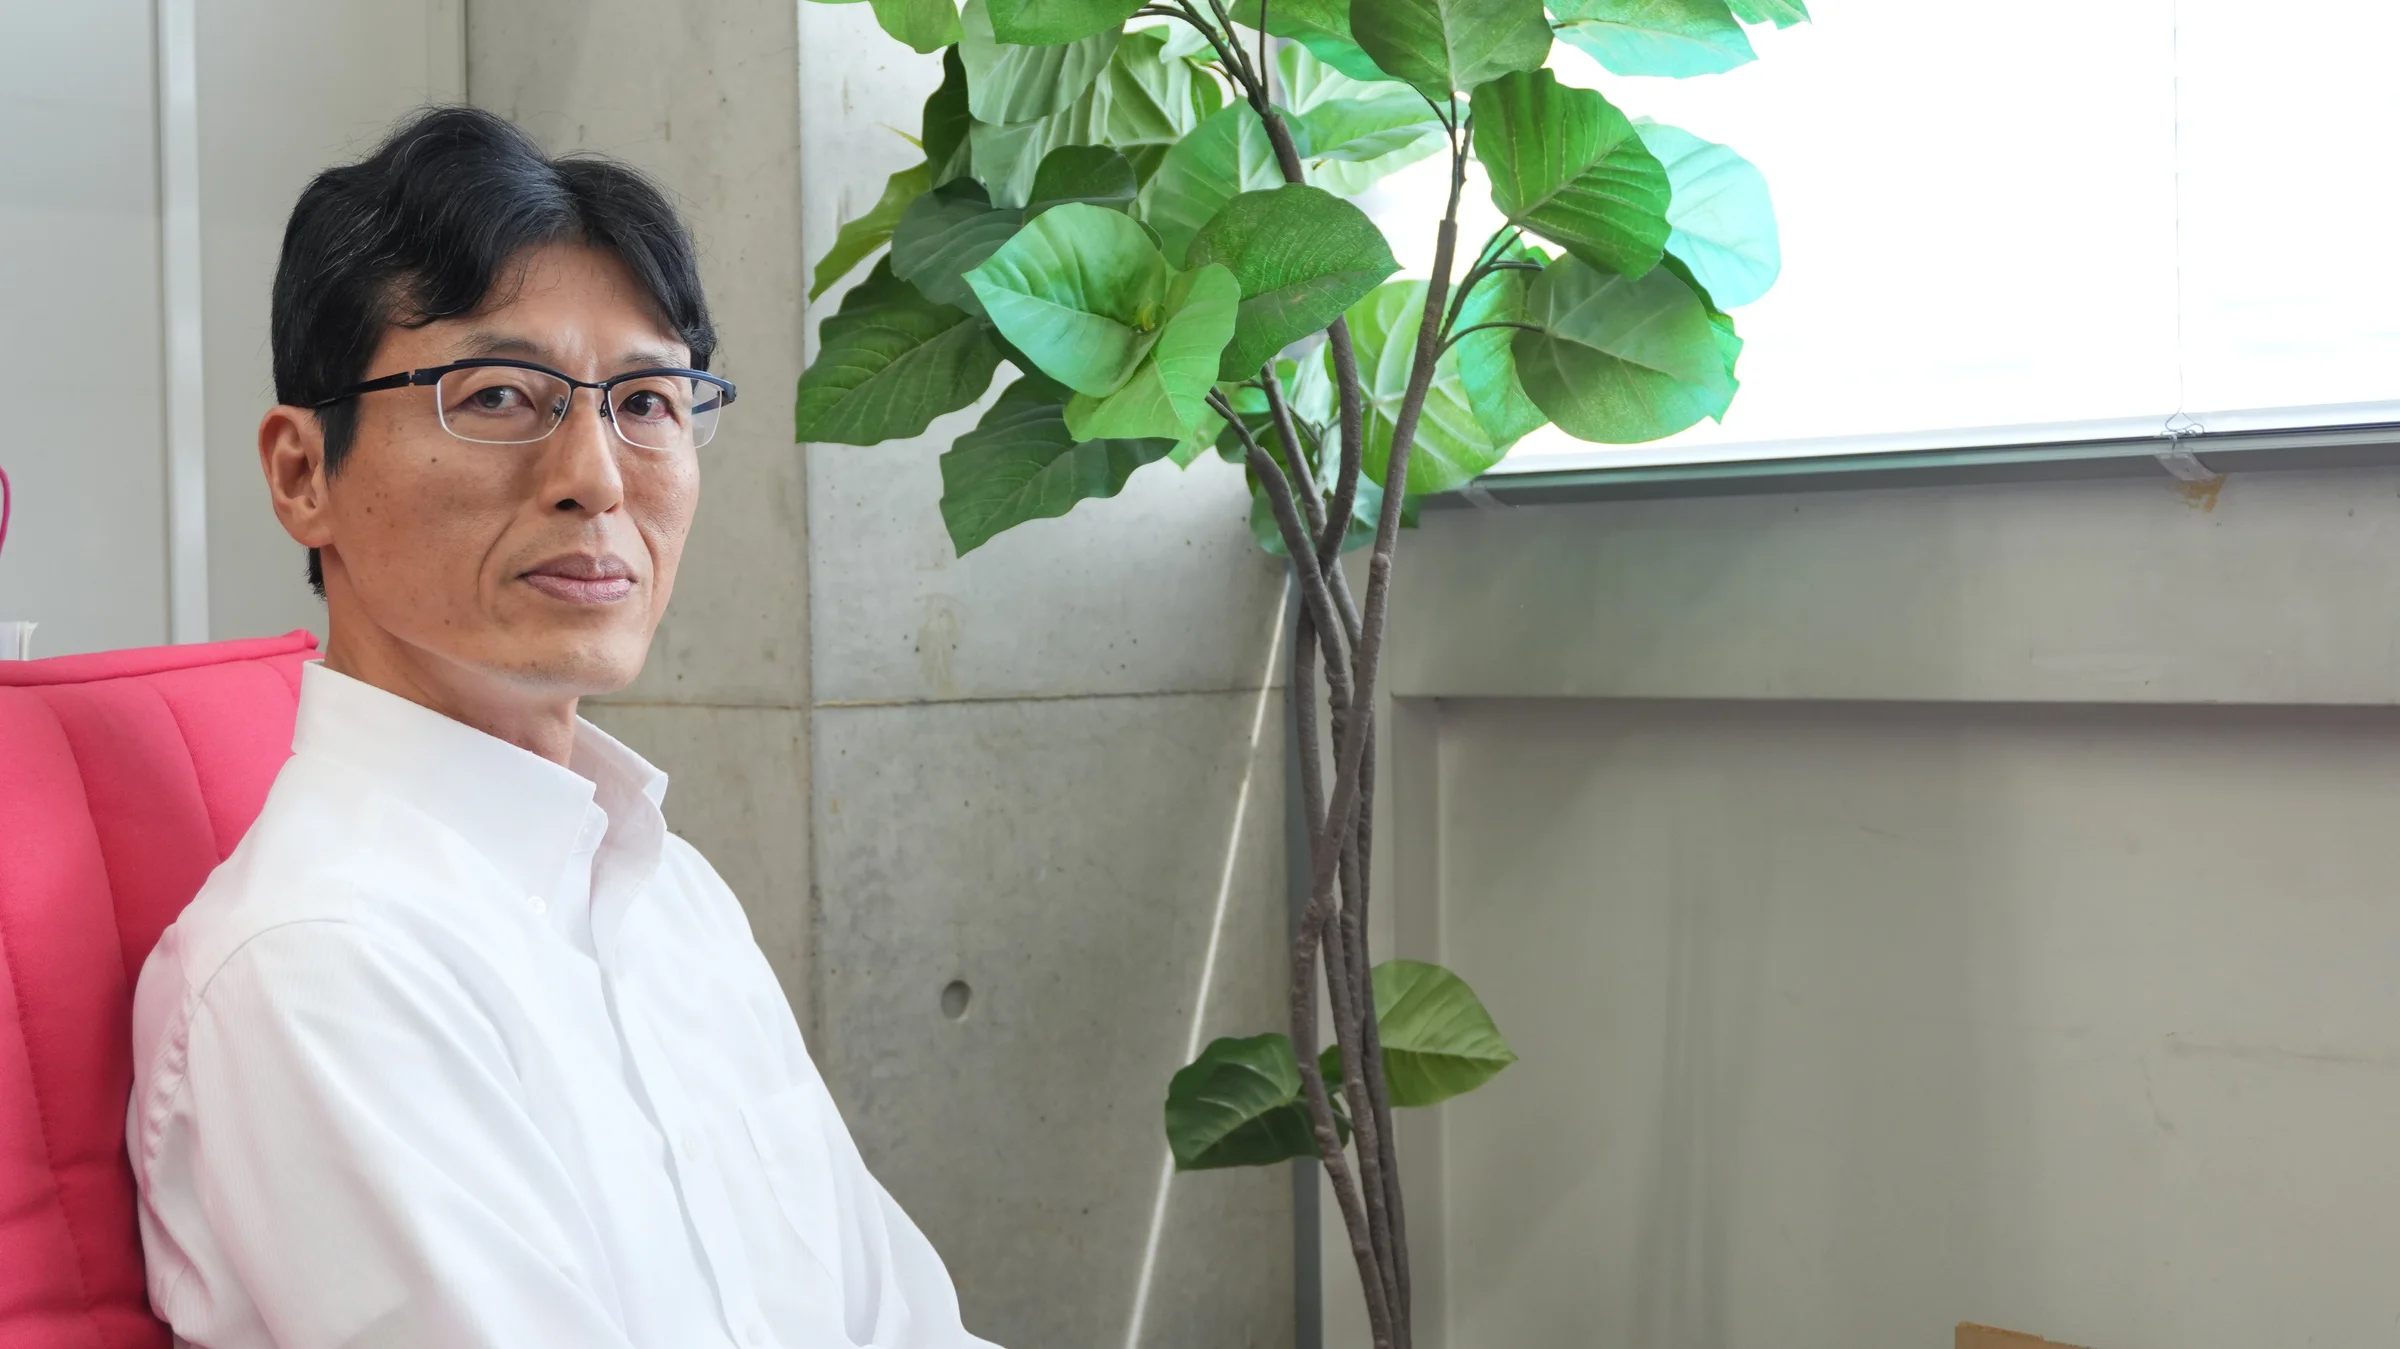
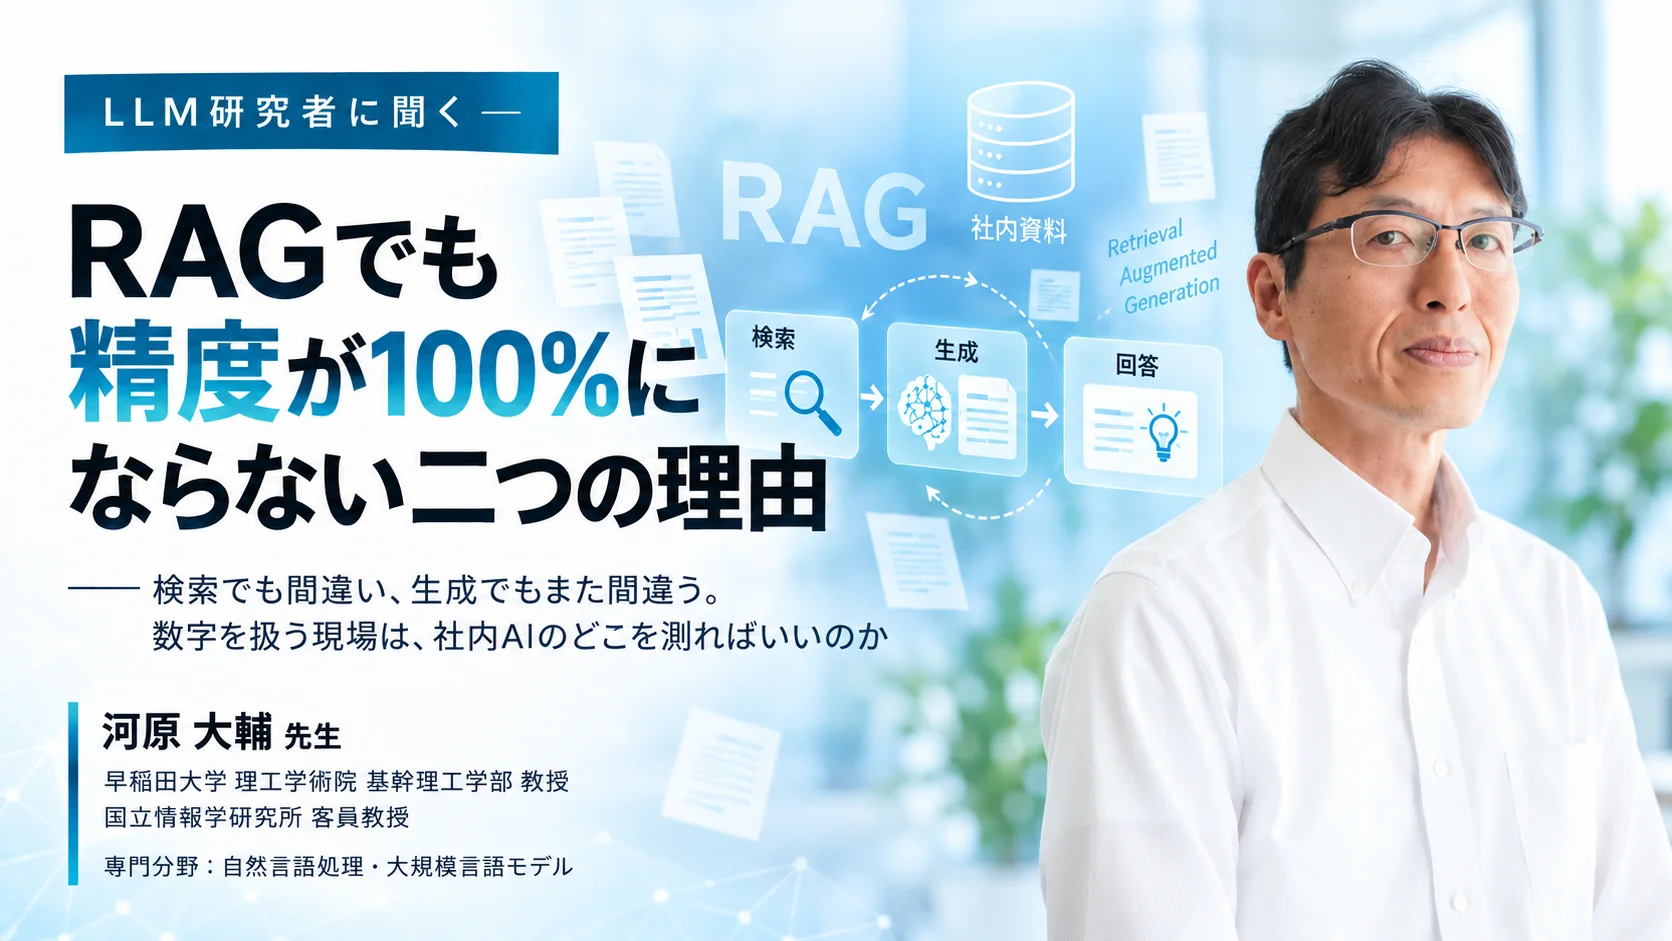
河原 大輔(かわはら・だいすけ)
早稲田大学 理工学術院 基幹理工学部 教授国立情報学研究所 客員教授専門分野:自然言語処理、大規模言語モデル日本語を中心に、大規模言語モデルの構築・評価・応用に取り組む。日本語の言語理解ベンチマーク「JGLUE」の構築で、言語処理学会の最優秀論文賞を受賞。
我慢できないから、答えてしまう
早押しクイズでは、読み上げの途中で解答権を取りにいきます。腕のある出場者ほど、手応えが出るまでは手を伸ばしません。河原教授の研究室は、この場面をAIに置き換えました。問いの文を頭のほうから100%、90%、70%、50%と削った状態で学ばせ、どこまで聞いた段階で答えの糸口をどれだけ引き出せるかを調べる、という組み立てです。
そこで浮かび上がったのが、押すタイミングの判断でした。
我慢ができない、と重ねて伺うと、返ってきたのは「情報量が足らないくせに、答えたがります」という一言でした。手元の材料が整わないうちに答えを出してしまう。そこで取り違えが生まれる、という説明です。
「分かりません」と返ってこないことを、答えられるだけの材料があった証拠として読んではいけない、ということになります。検証の入口としては、次の置き換えが効きます。
- ・答えが返ってきたことを、AIがその事柄を知っている根拠として扱わない
- ・「分からなければ分からないと書いて」と指示したうえで、それでも答えが返ってきたかを見る
- ・断定の強さと、確からしさを切り離して読む(言い切っているほど確かだ、とは限らない)
誤りは、知らない分野に偏る
では、どういう問いで間違えるのか。ここで挙がったのは、問題文の複雑さではありませんでした。
「似ているけれども、若干違う」。ここが、検証する側にとって一番やっかいなところです。まったく的外れな答えなら、その分野を知らない人でも引っかかります。ですが、惜しい間違いは、知っている人が読まなければ通り過ぎます。似た名前の人物、隣の年号、同じ制度の旧称——どれも、文章としては何の違和感もなく収まります。
なお、この話はウェブ検索を使わない条件下でのものだと教授は補足しています。検索して調べさせれば、Wikipediaなどに書かれている事柄はもう少し当たるようになる、と。
「ニッチかどうか」で間違えるのは、AIが学習したテキストの量が分野ごとに大きく偏っているからです。言語による偏りは、その分かりやすい例でした。
この偏りは、OpenAIが公表したGPT-3の学習データ構成にも表れています。語数で見ると英語が約92.6%を占め、日本語は約0.11%にとどまります。日本語でしか書かれていない細部は、そもそも学習の中にほとんど入っていなかったことになります。近年のモデルでは学習量も多言語のテキストも増えましたが、分野ごとの濃淡が消えたわけではありません。
検証の手間をどこに厚くするかは、この偏りから逆算できます。
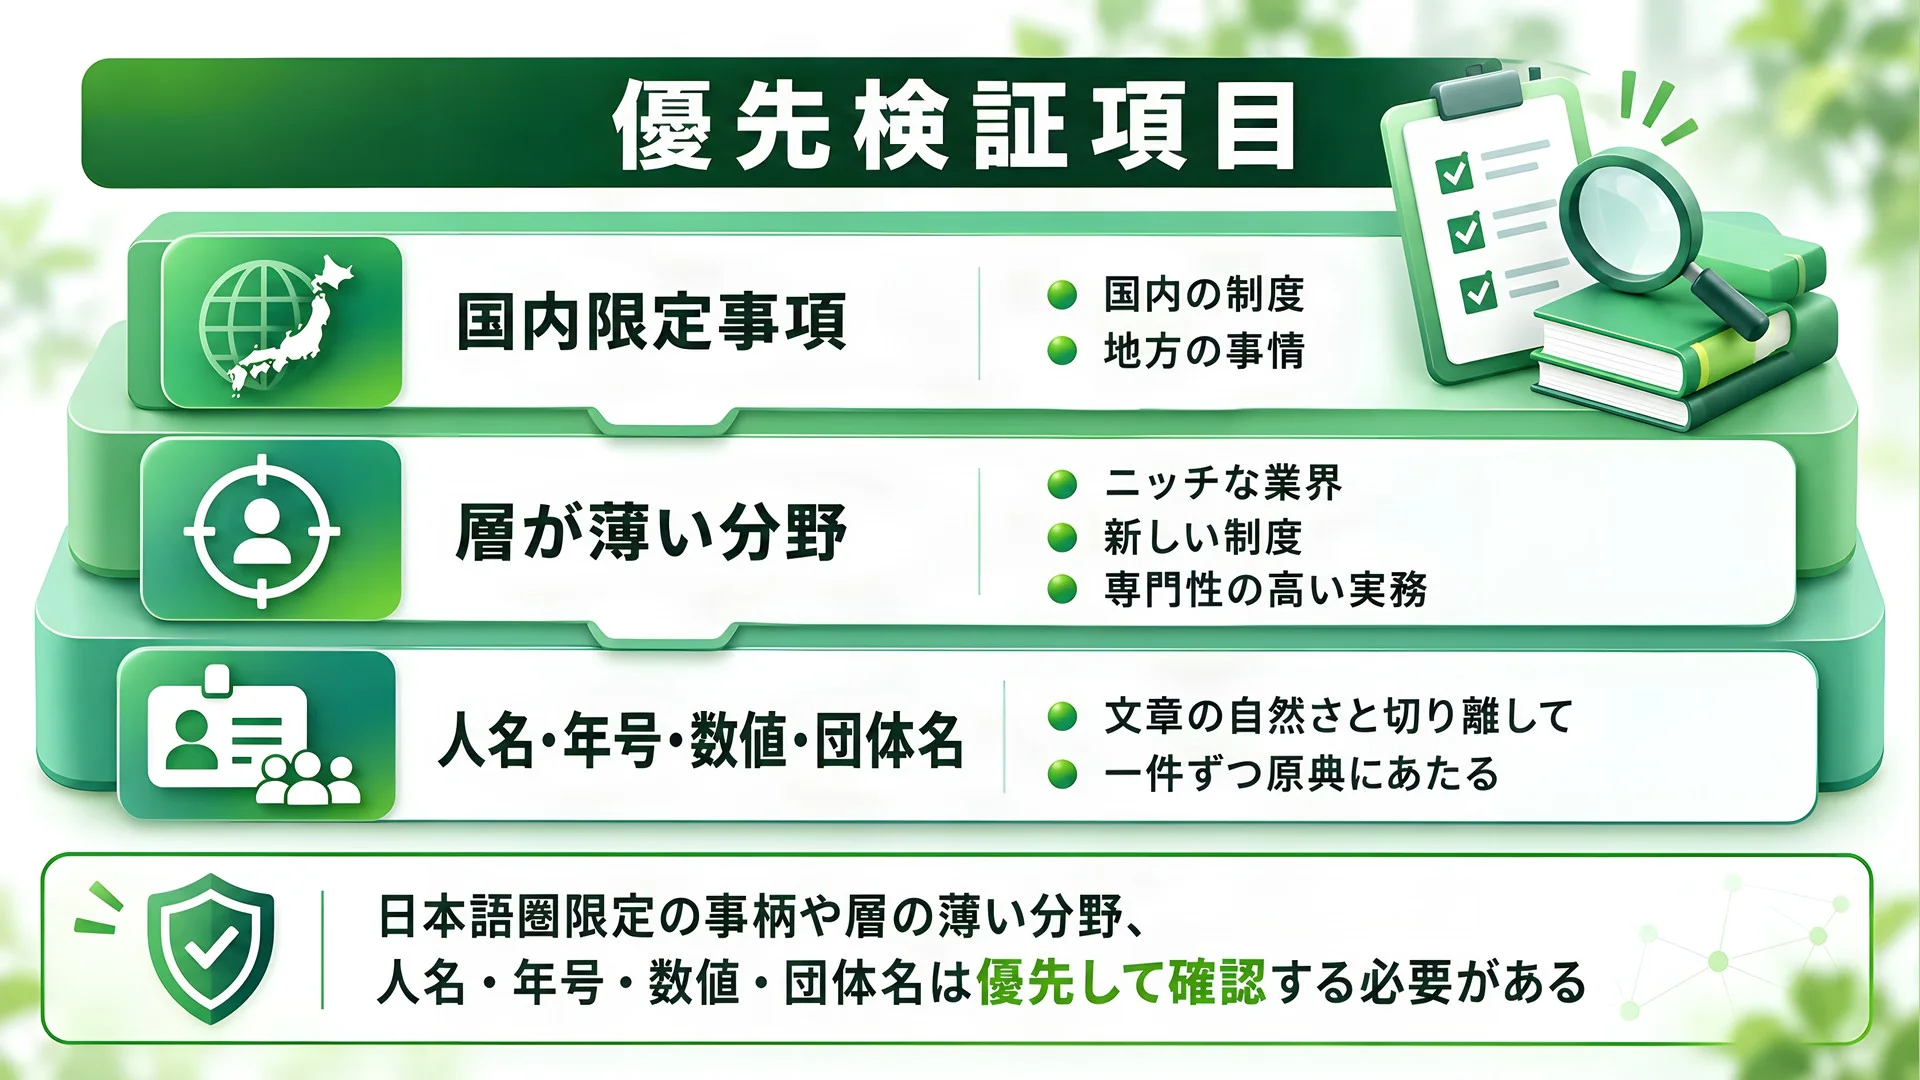
- ・日本語圏でしか書かれていない事柄(国内の制度、地方の事情、日本語の固有名詞)は、確認の優先順位を上げる
- ・分野として層が薄いもの(ニッチな業界、新しい制度、専門性の高い実務)を、同じ扱いにする
- ・人名・年号・数値・団体名は、文章の自然さと切り離して、一件ずつ原典にあたる
存在しない文献より、著者名だけが違う文献
AIの誤りに「うっかり騙されそうになった経験」を伺うと、河原教授が真っ先に挙げたのは、参考文献でした。丸ごと架空の論文が並ぶ例は、すでによく知られています。ですが教授が手元で見ているのは、もう一段見つけにくい壊れ方でした。
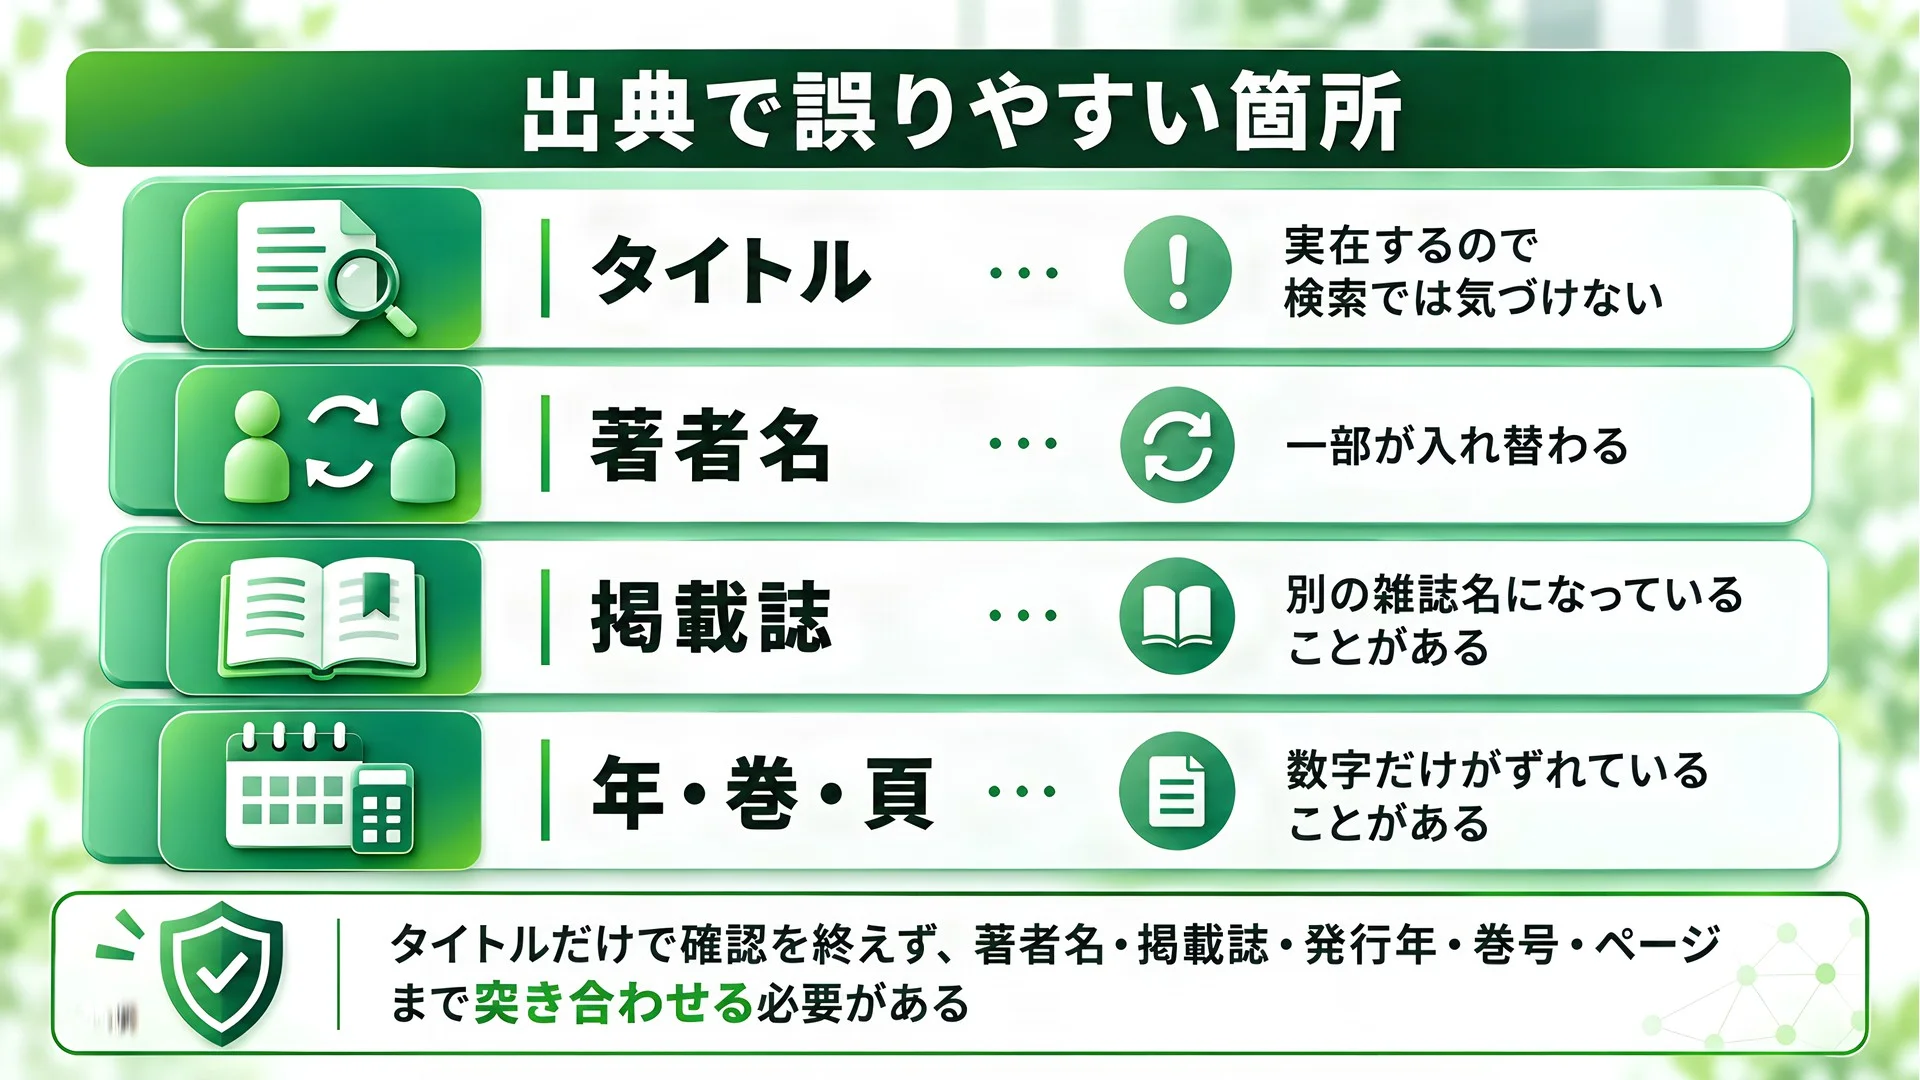
丸ごと架空の文献なら、検索して一件も出てこない時点で気づけます。ところがタイトルが実在すると、検索結果には該当の論文が出てきます。そこで確認をやめてしまえば、著者名の入れ替わりは原稿に残ります。ここでも「似ているけれども、若干違う」が効いているわけです。書誌情報はタイトル・著者・掲載誌・発行年・巻号・ページという複数の要素でできていて、崩れるのはそのうちの一部だけ、ということが起こります。
そして引用の誤りは、体裁の問題では済まなくなってきています。
| デスクリジェクトとは |
|---|
| 投稿された論文を、査読者に回す前の段階で編集者が却下すること。内容の評価に進まないまま、門前払いになります。 |
出典が1件おかしいだけで、中身を読まれる前に落とされる。学術の世界に限った話ではありません。記事に一つでも存在しない出典が載れば、問われるのは記事全体の信頼です。
- ・タイトルで検索して終わりにせず、著者名・掲載誌・発行年・巻号・ページまで一件ずつ突き合わせる
- ・検索で出てきたページのタイトルと、原稿に書かれたタイトルが完全に一致しているかを見る(似たタイトルの別論文がある)
- ・その出典が、原稿の主張を実際に支えているかを、本文まで開いて確かめる
褒めてくるのは、そう学習させたからです
誤りが出る場所は、知識の外側だけではありません。原稿や企画をAIに評価させると、たいてい褒められます。「忖度しないで」と添えたところで、その注文まで汲み取ったような、ひねった言い回しが返ってくる。結局、まともに評価されたのかどうかが分からなくなる——そう伺うと、教授はこの傾向をはっきり問題視しました。
「そう振る舞うように学習している」。つまり、褒めてくるのはAIの性格ではなく、そう仕上げられた結果だということです。開発側が意図的に調整しているのか尋ねると、答えは肯定でした。
褒めるか、冷たくするか。そのつまみは、事実かどうかとは別の場所にあります。原稿の良し悪しをAIに尋ねる場面が増えているぶん、この一点は押さえておく価値があります。返ってきた評価は、内容への評価であると同時に、褒めるように調整された結果でもあります。
- ・AIに「この原稿はどうか」と尋ねない。「事実と食い違う箇所を挙げて」と、確認できる形で尋ねる
- ・褒められたことを、確認を省く理由にしない
- ・「忖度しないで」と書き足すより、原稿を採用するかどうかの判断は人が下す、と決めておく
ここまでは、AIが単体で答えるときの話でした。では、社内の資料を読ませたうえで答えさせれば、誤りは減るのでしょうか。その答えをどこまで信じてよいかについては、別記事「大規模言語モデル研究者に聞く、RAGが100%にならない二つの理由」で伺っています。
AIの誤りは、均等にばらまかれてはいませんでした。層の薄い分野に偏り、惜しい間違いという形をとり、参考文献では一部の要素だけが入れ替わり、評価を求めれば褒めるほうに寄ります。どれも、出てきた文章の見た目には表れません。裏を返せば、どこを厚く確かめるかは先に決めておけるということです。全部を疑うのは続きませんが、偏りのあるところだけなら、手が届きます。
取材日:2026年8月17日
撮影:編集部
この記事を書いた人
編集プロダクション雨輝
2014年創業。取材・執筆、編集、校正・校閲、ファクトチェックなど、コンテンツ制作を幅広く手がける編集プロダクション。正確性と信頼性を重視し、専門家への取材や一次情報の確認を通じた、質の高い情報発信に取り組んでいる。https://amaterupro.jp/